
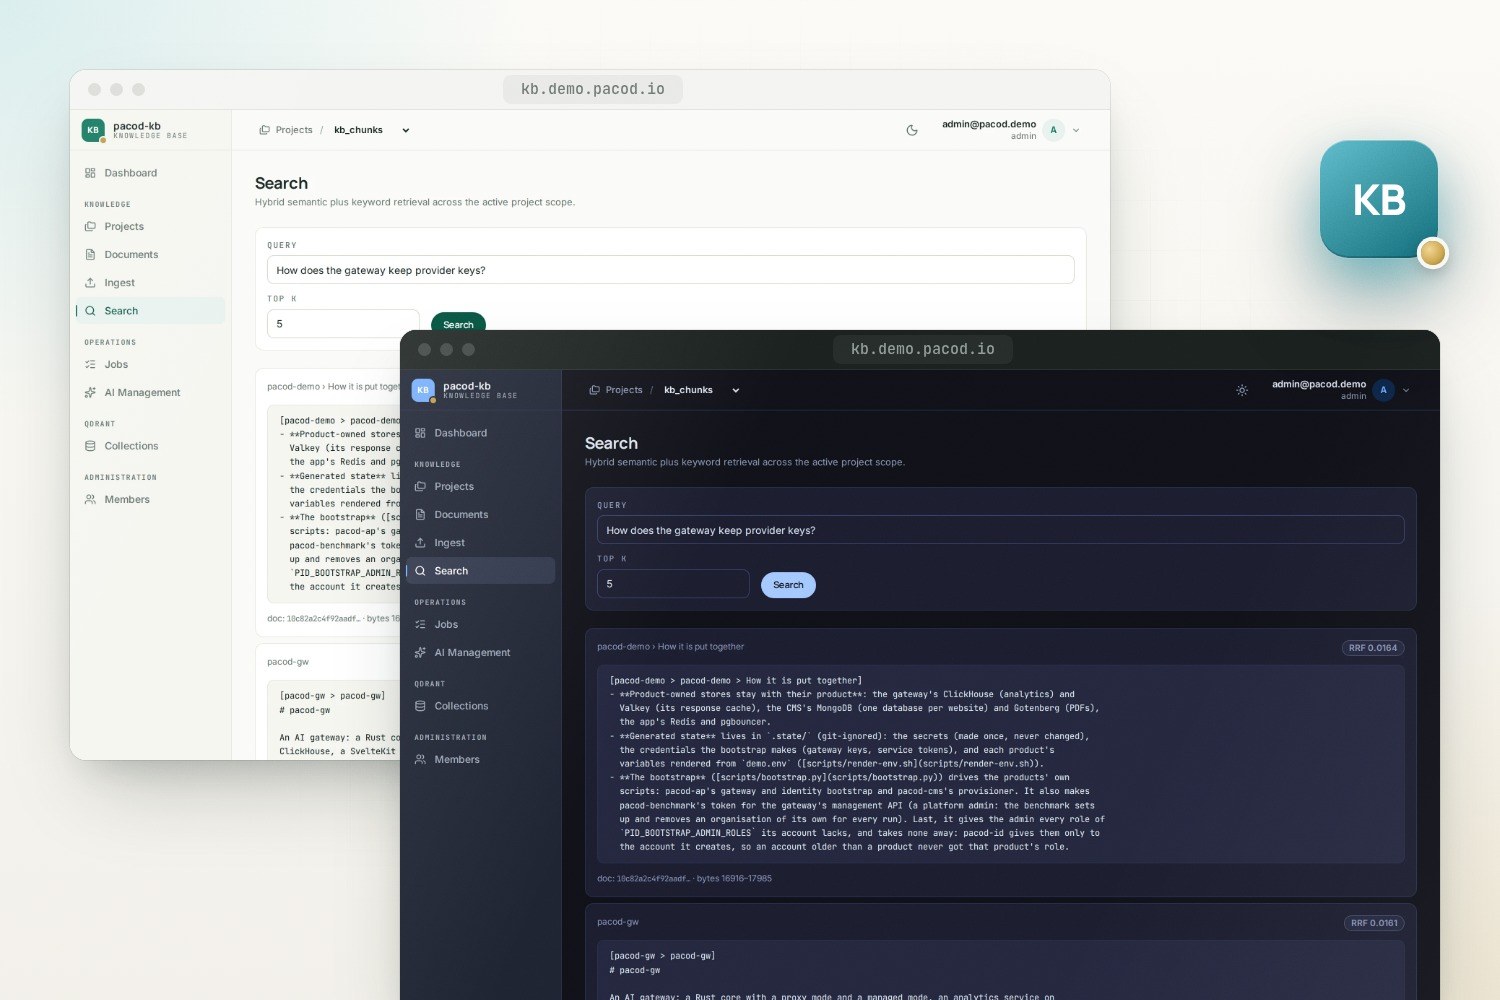
pacod-kb nimmt Dateien und Webseiten auf, wandelt sie in kanonisches Markdown um, indexiert sie für hybride semantische und Schlüsselwortsuche und bewahrt jede Version auf. Jedes Dokument wird auf Prompt Injection gescannt, bevor irgendetwas indexiert wird, und nachgelagerte Modelle erhalten zitierbare Passagen unter einem dokumentierten Metadatenvertrag. Es läuft auf der CPU, und Suchen bleiben reaktionsschnell, während Dokumente aufgenommen werden.
RAG-Wissensdatenbank
- Lizenz: Apache-2.0
- Version: 1.0.0 · Stabil
- Geschrieben in: Python
- Tech-Stack: FastAPI, HTMX, docling, BGE-M3, Qdrant, SQLite FTS5, PostgreSQL, Docker
- Auf GitHub ansehen · Issue eröffnen
Funktionen
Alles aufnehmen
PDF, DOCX, HTML, Markdown, Text und JSON — hochgeladen, in einen Ordner gelegt, von einer URL abgerufen oder auf Änderungen überwacht.
Kanonisches Markdown
Überschriften werden in Rechtstexten in acht Sprachen, in wissenschaftlichen Arbeiten und in Artikeln erkannt; Seitenzahlen, laufende Kopfzeilen und Boilerplate werden herausgefiltert.
Inhaltssicherheit
Ein mehrstufiger Scan auf Prompt Injection und Spam blockiert ein Dokument oder stellt es unter Quarantäne, bevor es indexiert wird; Suchergebnisse werden als nicht vertrauenswürdige Daten eingezäunt.
Hybride Suche
Dichte BGE-M3-Vektoren in Qdrant plus ein Schlüsselwortindex, zusammengeführt per Reciprocal Rank Fusion, in Projekten, die die Dokumente der anderen nie zu sehen bekommen.
Jede Version bleibt erhalten
Eine neue Version löst die alte ab, die nach Datum durchsuchbar bleibt; kehrt eine überwachte Seite zu einem früheren Stand zurück, wird die frühere Version wieder in Kraft gesetzt.
Kalibrierte Relevanz
Ein optionaler Cross-Encoder-Reranker liefert einen Relevanzwert von 0–1, der über Abfragen hinweg Bestand hat, sodass min_score Nicht-Antworten aussortieren kann.
Ein Vertrag für Konsumenten
Jede Passage trägt eine stabile ID, ihren Überschriftenpfad und Byte-Offsets in das gespeicherte Markdown, Feld für Feld dokumentiert.
Für die CPU gemacht
Abfragen haben Vorrang vor der Aufnahmearbeit und warten höchstens auf einen kleinen Batch; Embeddings können auch von einem gemeinsamen Dienst kommen.
Web-UI und CLI
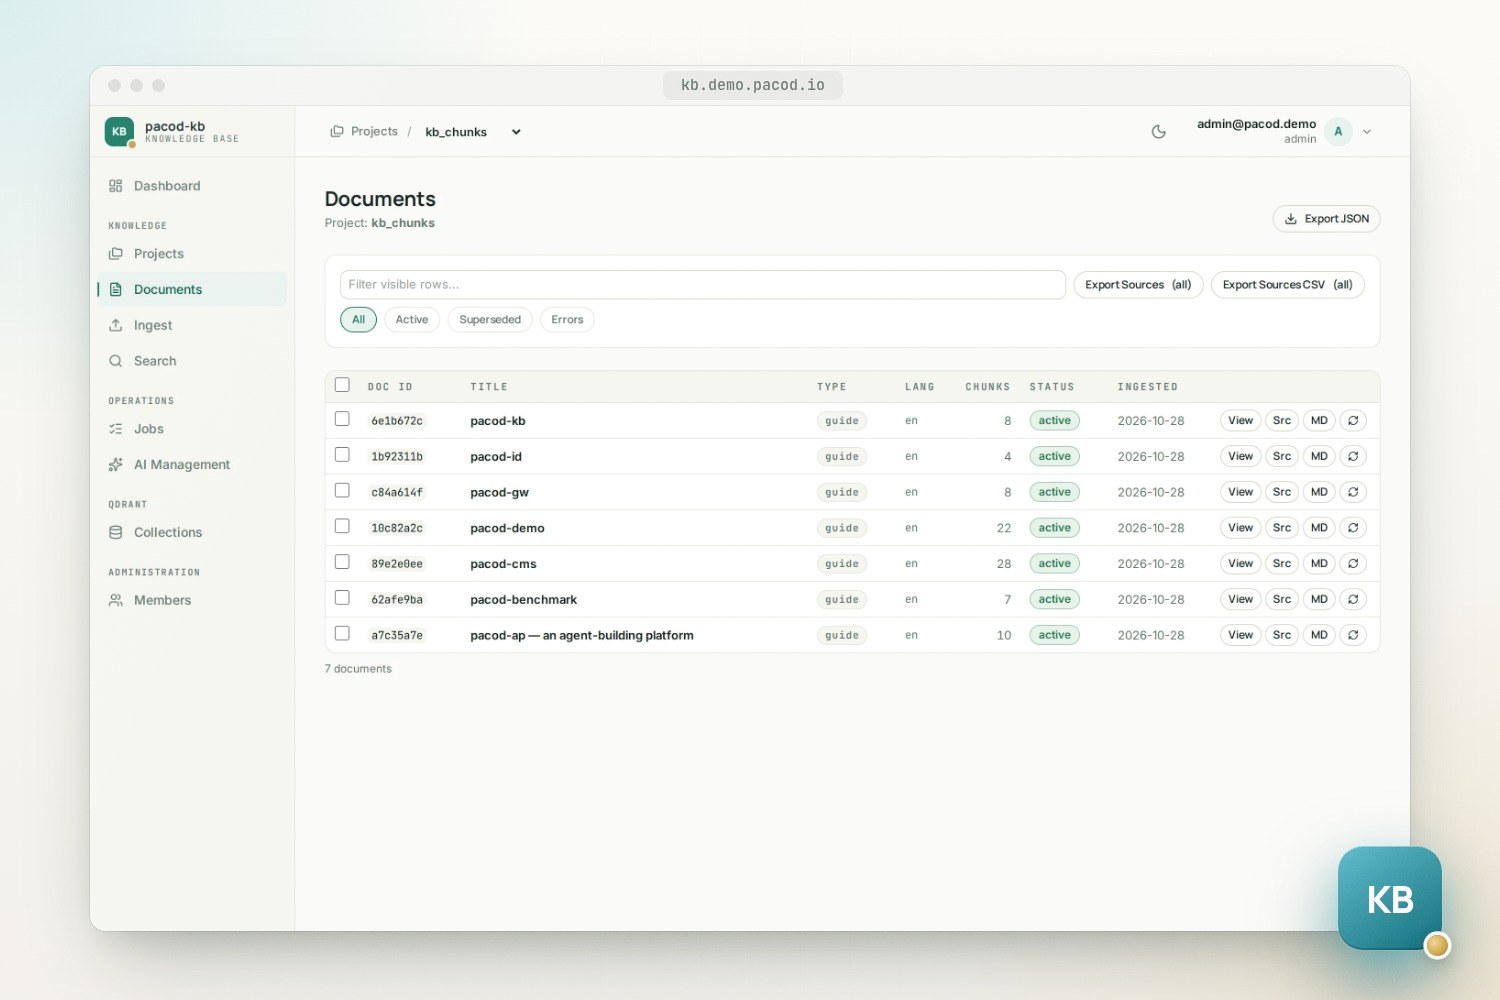
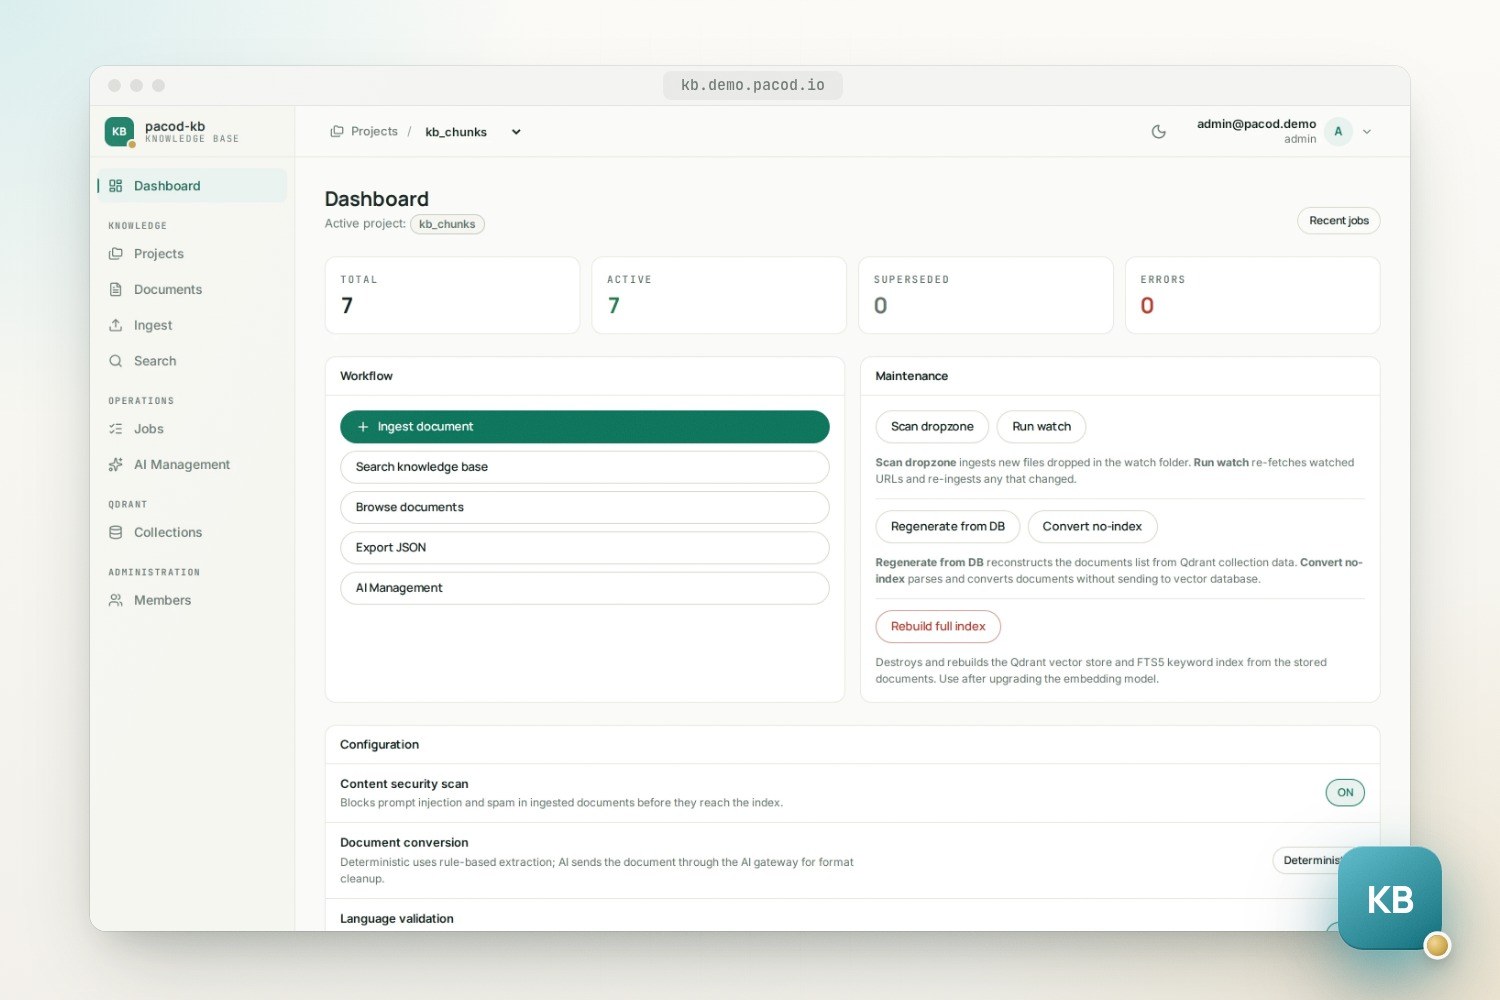
Eine Web-UI im gemeinsamen pacod-Look, hell oder dunkel, für Dokumente, Projekte, Jobs, KI-Nutzung und -Kosten sowie Mitglieder; das CLI kb für Aufnahme, Suche, Überwachung, Neuaufbau und Export.
Screenshots
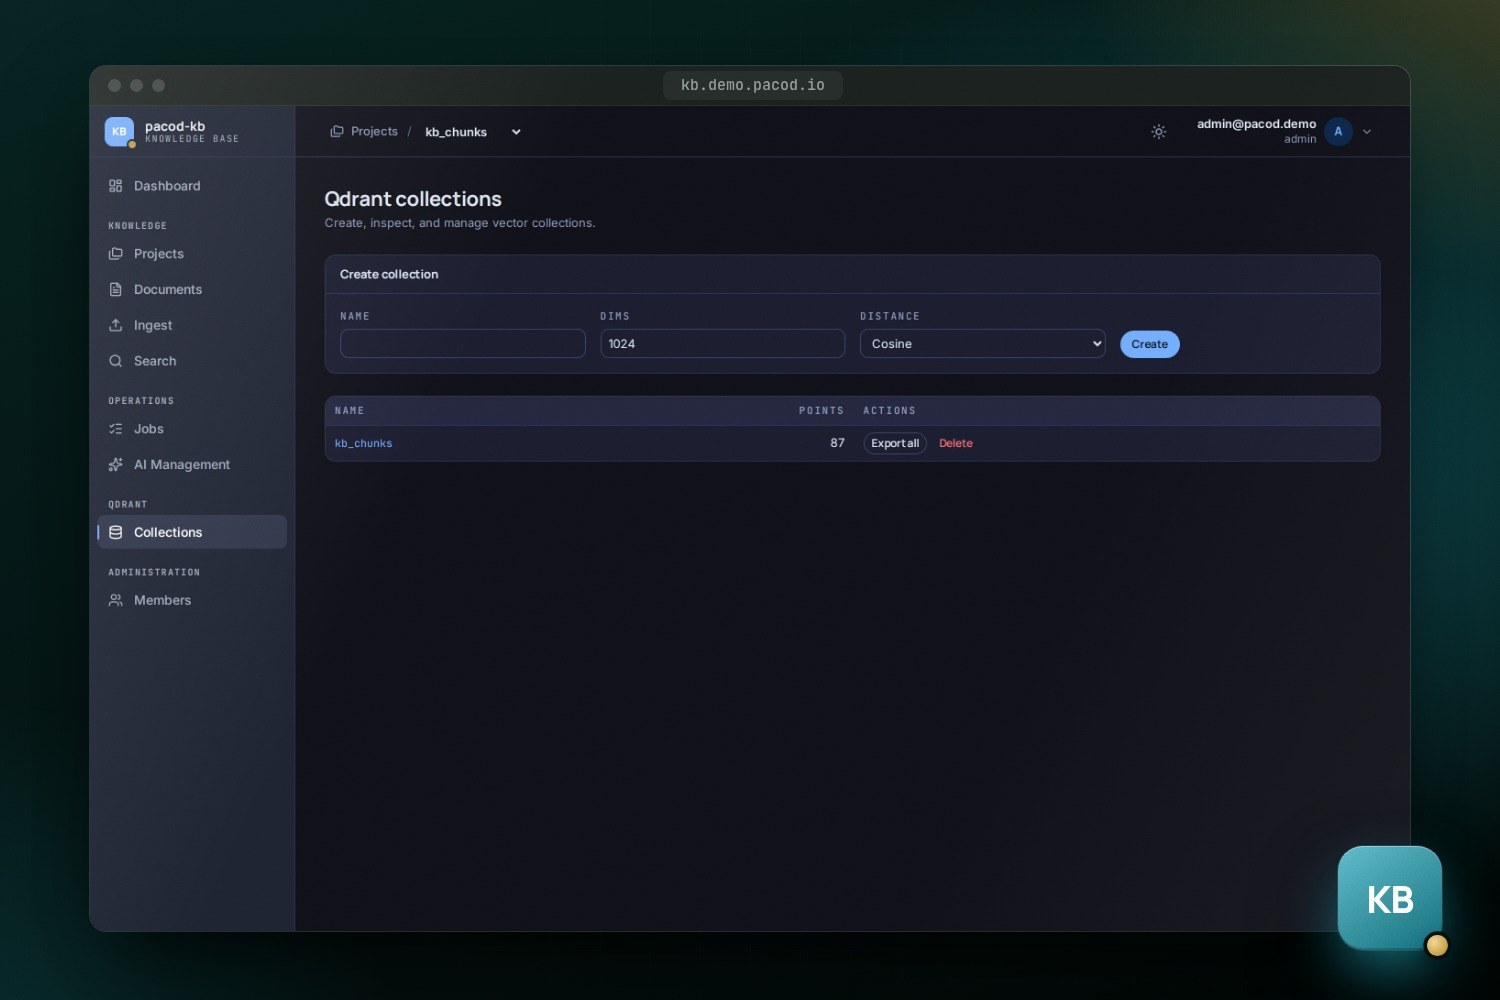
Warum es das gibt
Der größte Teil der Arbeit in Retrieval-Augmented Generation passiert, bevor ein Modell ein Wort liest: Dokumente hineinbekommen, sie sauber halten, die richtige Passage finden und dem Modell sagen, woher sie stammt. pacod-kb ist genau dieser Teil, gebaut als eigener Dienst mit einer HTTP-API, einer Web-UI und einem CLI.
Drei Anforderungen haben es geprägt:
- Antworten müssen zitierbar sein. Jede Passage trägt ihren Überschriftenpfad und Byte-Offsets in einen stabilen Markdown-Text, sodass ein Konsument sie zitieren, verlinken und ihren Kontext abrufen kann.
- Quellen ändern sich. Nichts wird überschrieben: Eine neue Version löst die alte ab, die nach Datum durchsuchbar bleibt.
- Aufgenommener Text ist für ein Modell nicht vertrauenswürdige Eingabe. Er wird vor dem Indexieren auf Prompt Injection gescannt und bei der Ausgabe als Daten eingezäunt.
Ein Dokument, Schritt für Schritt
Ein Dokument nimmt denselben Weg, ob es hochgeladen, im Dropzone-Ordner abgelegt, von einer URL abgerufen oder von einer überwachten Webquelle erneut geholt wurde:
- Erfassen. Der SHA-256 der Quellbytes ist die Dokument-ID; eine bekannte ID wird übersprungen, dieselbe Datei wird also nie zweimal aufgenommen.
- Parsen. PDF über docling, mit optionaler OCR für gescannte Seiten (ist tesseract installiert, werden zwei Engines Seite für Seite verglichen), DOCX, HTML, Markdown, Text und JSON, dessen Schlüssel zu Überschriften werden. Das Ergebnis ist Markdown mit YAML-Front-Matter.
- Sprache prüfen. Englisch, Deutsch, Bulgarisch, Russisch, Serbisch, Mazedonisch, Kroatisch
und Slowenisch werden angenommen, andere Sprachen abgelehnt, bevor irgendetwas geschrieben wird.
Text, dessen Sprache sich nicht erkennen lässt, wird als
unknownangenommen, mit einer Warnung. - Scannen des deterministischen Parsing-Ergebnisses auf Prompt Injection und Spam. Das geschieht, bevor irgendein Modell den Text sieht: Ein Konverter könnte eingeschleusten Anweisungen folgen, und die Umwandlung würde die Nullbreitenzeichen und das versteckte Markup entfernen, nach denen der Scan sucht.
- Umwandeln, optional. Ein LLM-Durchlauf über pacod-gw räumt das Markdown auf; ein PDF bis 20 MiB geht als Datei an das Modell, alles andere als extrahierter Text. Ein Dokument in Quarantäne wird nie gesendet. Eine abgeschnittene, verweigerte oder leere Antwort lässt das deterministische Parsing-Ergebnis stehen, und ein umgewandelter Text wird ein zweites Mal gescannt.
- Bereinigen und strukturieren. Ein Rauschfilter entfernt Seitenzahlen, laufende Kopfzeilen, Cookie-Hinweise und Blöcke aus Navigationslinks. In Gesetzbüchern, Verordnungen und Richtlinien (acht Sprachen) sowie in wissenschaftlichen Arbeiten werden Überschriften als solche ausgezeichnet; ein Artikel von einer URL erhält außerdem Autor, Datum und Publikation.
- Speichern von
document.md, einem Manifest mit seinem Lebenszyklus-Protokoll und einem Snapshot der Quelle: in Ordnern unterKB_ROOToder in PostgreSQL. - Indexieren, nur wenn der Status des Dokuments
okist. Überschriftenbewusste Chunks von bis zu 500 Tokens werden mit BGE-M3 eingebettet, jeder mit einem vorangestellten Brotkrumenpfad[Title > Heading > Subheading](eine Tabelle bekommt zusätzlich den Absatz davor), und landen in der Qdrant-Collection und im Schlüsselwortindex des Projekts. Chunks, die seit einer früheren Version unverändert sind, behalten ihre Vektoren.
Aufnahmen aus der UI oder über die API laufen als Jobs, einer nach dem anderen auf einem eigenen Worker, nie auf den Threads, die Suchen beantworten. Im Datenbankmodus werden Jobs in PostgreSQL gehalten, und ein Neustart markiert die, die er unterbrochen hat, als fehlgeschlagen.
Architektur
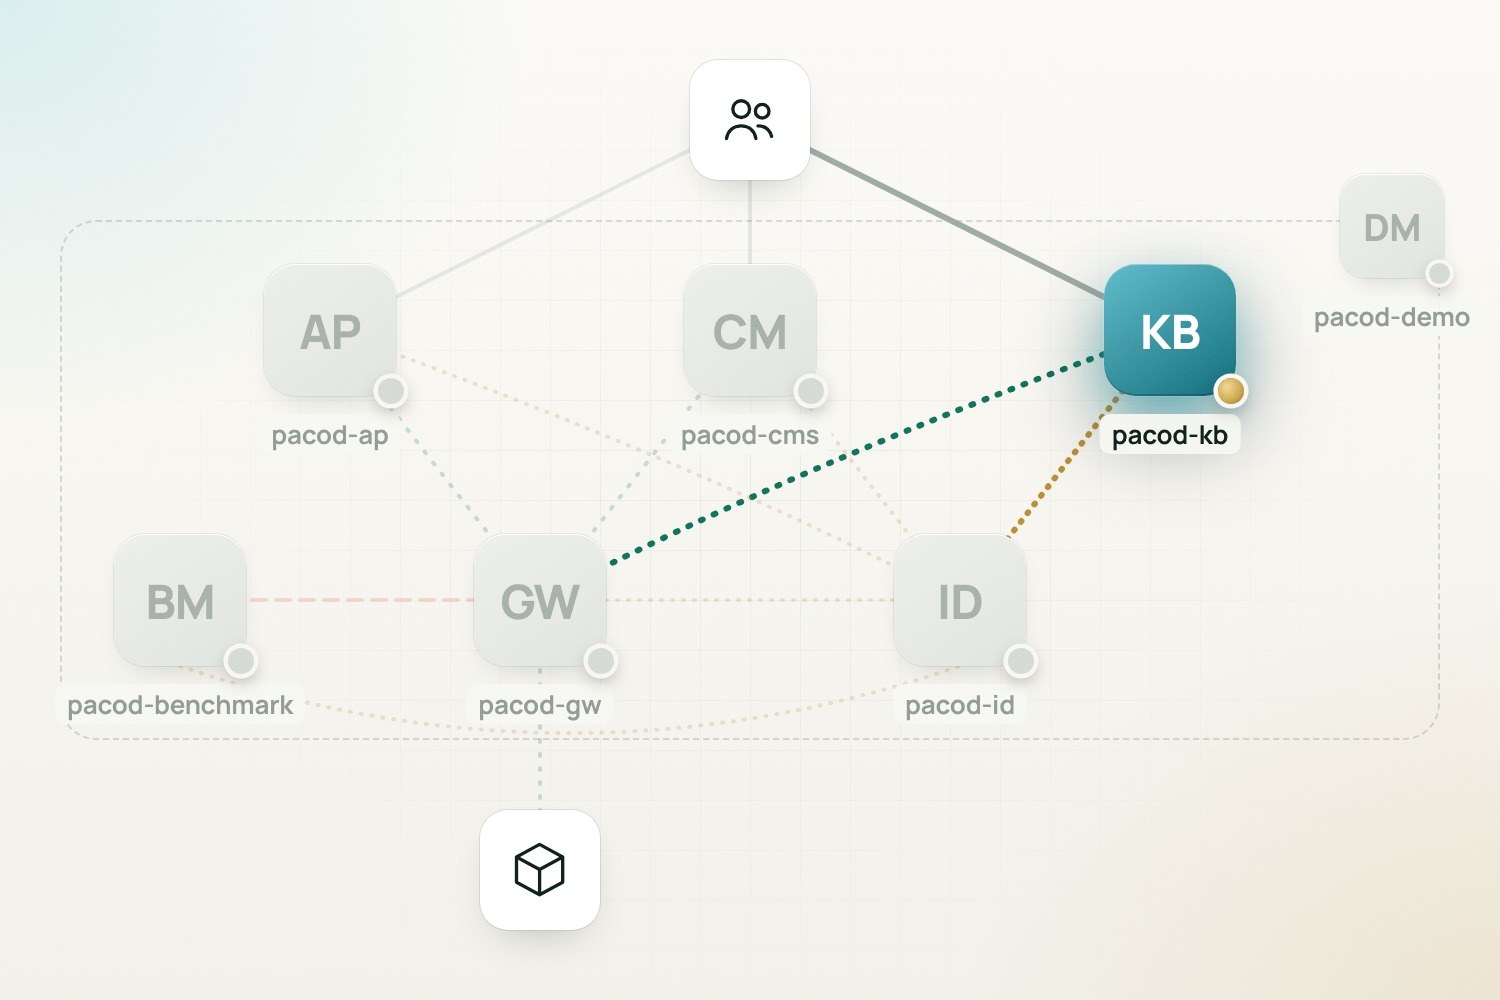
pacod-kb besteht aus zwei Diensten, kb-pipeline und kb-ui, dazu den Modellen und Speichern, die sie nutzen:
| Teil | Aufgabe |
|---|---|
Pipeline-API (kb-pipeline, :8000) |
Aufnahme, Indexierung, Suche, Jobs, Einstellungen; der einzige Teil, der das KI-Gateway aufruft |
Web-UI (kb-ui, :8080) |
FastAPI und HTMX; Anmeldung über pacod-id, Sitzungen, Mitglieder, die Seiten; ruft die Pipeline mit einem API-Schlüssel auf |
| BGE-M3 | 1024-dimensionale Embeddings, im eigenen Prozess der Pipeline oder vom Embeddings-Dienst von pacod-ap |
| Qdrant | Die Vektoren: eingebettet in die Pipeline oder als Server, den auch andere Produkte nutzen können |
| Schlüsselwortindex | SQLite FTS5 (BM25) bei Speicherung im Dateisystem, PostgreSQL-Volltextsuche bei Speicherung in der Datenbank |
| Dokumente und Ledger | Ordner unter KB_ROOT oder PostgreSQL; das Ledger hält Einstellungen, Prompts, KI-Nutzung und -Kosten |
Die Trennung ist gewollt. Die Pipeline parst nicht vertrauenswürdige Dokumente und ruft beliebige URLs ab, deshalb erhält sie keines der Geheimnisse von pacod-id; die UI bekommt den Gateway-Schlüssel nie zu sehen. Jeder Container erhält eine explizite Liste von Umgebungsvariablen, und ein Test prüft diese Liste.
Jeder Container tritt dem gemeinsamen Docker-Netzwerk pacod-net bei, in dem jeder die anderen
erreichen kann. Der interne Listener von pacod-id (Tokens, Signaturschlüssel, der
Autorisierungs-Feed, die Admin-API) ist die Ausnahme: Er antwortet nur in pacod-admin-net, einem
internen Netzwerk ohne Route nach außen, als pacod-id-internal:8071. kb-ui tritt diesem Netzwerk
bei; die Pipeline nicht, und sie kann ihn nicht erreichen.
Wer gehandelt hat. Jeder Aufruf aus der UI trägt X-KB-Actor, die ID der angemeldeten Person.
Die Pipeline vertraut diesem Header nur zusammen mit dem API-Schlüssel, vermerkt die ID an Jobs,
Einstellungsänderungen und Nutzung und reicht sie an das Gateway weiter. Löscht pacod-id ein Konto,
beendet kb dessen Sitzungen, ersetzt diese ID überall durch deleted-user und bestätigt erst dann
die Löschung.
Die Suche und was ein Modell bekommt
Eine Abfrage läuft gegen Qdrant und den Schlüsselwortindex, und die beiden Rankings werden per Reciprocal Rank Fusion zusammengeführt: Jede Liste addiert 1/(60 + Rang) für jede Passage, die sie gefunden hat. Datums- und Verlaufsfilter greifen innerhalb beider Suchen, sodass hundert abgelöste Passagen die eine, die gültig ist, nicht verdrängen können.
Ein RRF-Wert ordnet eine Ergebnisliste und bedeutet über Abfragen hinweg nichts. Ein Wert von
0,0164 ist 1/61: Platz eins in einer Liste und in der anderen gar nicht vorhanden. Genau das
bekommen die meisten natürlichen Fragen standardmäßig, weil die Schlüsselworthälfte
(KEYWORD_QUERY_MODE=legacy) verlangt, dass jedes Wort der Abfrage passt. Die analysierten Modi
(or, and_or) lassen stattdessen Stoppwörter weg und führen Wörter auf ihren Stamm zurück; sie
bleiben aus, bis eine Evaluierung zeigt, dass sie helfen.
Ein optionaler Cross-Encoder, BAAI/bge-reranker-v2-m3, ordnet die besten zehn Kandidaten neu und
gibt jedem eine Relevanz zwischen 0 und 1, die über Abfragen hinweg vergleichbar ist, sodass
min_score Nicht-Antworten aussortieren kann. Er lädt im Hintergrund, sobald er eingeschaltet wird,
und eine Anfrage lädt ihn nie.
POST /query nimmt die Frage und ihre Filter entgegen:
{"query": "maximum fine for a data breach", "top_k": 5, "as_of": "2025-12-30"}
Die Antwort ist {"results": [...], "reranked": false, "score_kind": "rrf"}. Jedes Ergebnis
enthält:
| Feld | Wofür |
|---|---|
chunk_id |
Eine stabile ID, die die Überschriftenstruktur kodiert, keine laufende Nummer |
source_id |
Die Dokument-ID: der SHA-256 der Quellbytes |
heading_path |
Ein Brotkrumenpfad wie ["Chapter 1", "§ 5"], für Zitate und Abschnittsfilter |
byte_start, byte_end |
UTF-8-Offsets in den gespeicherten Markdown-Text |
valid_until |
Wann diese Version abgelöst wurde, oder null, solange sie aktuell ist |
text |
Der eingebettete Text, als nicht vertrauenswürdige Daten eingezäunt |
score, rrf_score, rerank_score |
Der Sortierwert und seine Bestandteile |
Die Offsets sind Bytes, keine Zeichen, was bei kyrillischem Text einen Unterschied macht:
body_bytes = body.encode("utf-8")
passage = body_bytes[result["byte_start"]:result["byte_end"]].decode("utf-8")
Jedes Dokument hat außerdem ein Manifest: Titel, Quelle, Dokumenttyp, Status, Projekt, der Parser
oder das Gateway-Modell, das den Text erzeugt hat, und ein Lebenszyklus-Protokoll (ingested,
superseded, reinstated, security_flagged, review_flagged, llm_usage).
Versionen und Projekte
Eine mit --supersedes aufgenommene neue Version oder eine überwachte Quelle, die sich geändert
hat, markiert die alte mit valid_until, an vier Stellen zugleich: im Front Matter, im Manifest,
im Schlüsselwortindex und in den Vektor-Payloads. Suchen liefern standardmäßig aktuelle Passagen;
as_of liefert, was an einem bestimmten Tag gültig war; include_historical liefert alles. Kehrt
eine überwachte Seite zu einem früheren Stand zurück, wird die frühere Version wieder in Kraft
gesetzt. Im Dateisystemmodus wird mit GIT_AUTOCOMMIT=true außerdem jede Aufnahme in ein
Git-Repository in KB_ROOT committet.
Ein Projekt ist eine isolierte Sammlung: eine eigene Qdrant-Collection und eigene Zeilen im
Schlüsselwortindex. Eine Suche sieht ein Projekt, ein Neuaufbau verwirft den Index eines Projekts
und füllt ihn neu (--all-projects baut jedes in seine eigene Collection neu auf), und das Wechseln
des aktiven Projekts wird verweigert, solange ein Job wartet oder läuft.
Gemessene Suche
Die Standardwerte stammen aus einem Evaluierungs-Harness: 14 Dokumente in sechs Sprachen (DSGVO, die Richtlinie zum Datenschutz bei Polizei und Justiz, vier Verfassungen, Wikipedia-Artikel) und 92 handgeschriebene Abfragen: Paraphrasen, exakte Begriffe, sprachübergreifende, muttersprachliche und unbeantwortbare. Ein Ergebnis zählt, wenn es aus dem annotierten Abschnitt stammt, sodass die Annotationen Änderungen am Chunker überstehen. Gemessen wurde auf der CPU eines Entwicklungsrechners (Apple M5, vier Threads), und die Doku betont, dass das keine Produktionszahlen sind:
| Messgröße | Ergebnis |
|---|---|
| Richtiger Abschnitt unter den fusionierten Kandidaten | bei jeder beantwortbaren Abfrage |
| Richtiger Abschnitt unter den ersten fünf, ohne Reranker | 98,7 % (R@1 0,83, etwa 50 ms) |
| Mit Reranker, zehn Kandidaten | R@1 0,91, etwa 2 s pro Abfrage |
| Eine Suche, während Dokumente aufgenommen werden (p50) | vorher 24,3 s; jetzt 0,41 s, mit nacheinander laufenden Jobs |
| Embedding bei der Aufnahme, nach Länge sortierte Batches | etwa 2,2× schneller, Vektoren unverändert |
Der Wert des Rerankers trennt Antworten von Nicht-Antworten: min_score 0.1 sortiert 14 von 15
unbeantwortbaren Abfragen und 2 von 70 richtigen Top-Antworten aus, wo RRF-Werte sie überhaupt
nicht trennen konnten. Standardmäßig ist er trotzdem aus: Sein Gewinn blieb auf der
zurückgehaltenen Hälfte knapp unter der Schwelle, und seine Latenz muss erst auf der
Produktions-CPU bestätigt werden.
Die analysierten Schlüsselwortmodi halfen bei muttersprachlichen Abfragen und exakten Begriffen,
kosteten aber mehr bei sprachübergreifenden und paraphrasierten und verloren auf der
zurückgehaltenen Hälfte: legacy bleibt der Standard.
Sicherheitsmodell
Inhaltssicherheit. Der Scan arbeitet auf einer normalisierten Kopie des Textes (Unicode-normalisiert, in Kleinbuchstaben, gesperrt geschriebene Wörter zusammengezogen) und wendet Regeltabellen an: Injection-Phrasen auf Englisch, Deutsch, Russisch und Bulgarisch, Tricks mit Bidi-Overrides und Nullbreitenzeichen, Base64- und Hex-Blobs (dekodiert und erneut gescannt), verstecktes Markup und Spam-Kennzahlen wie Linkdichte und wiederholte Zeilen. Jede Regel hat einen Schweregrad. Als hoch gelten nur eine eindeutige Übersteuerung der Anweisungen („ignore previous instructions“), ein Bidi-Override-Zeichen oder eine in Base64 versteckte Anweisung; Phrasen, die auch in technischen Texten vorkommen, etwa „enable developer mode“, gelten als niedrig, sodass ein einzelner Treffer kein Dokument blockieren kann. Tests prüfen, dass lange Gesetzestexte, darunter die DSGVO, als unbedenklich durchgehen. Das Urteil ist eines von dreien:
- block: ein Befund mit hohem Schweregrad oder ein hoher Bedrohungswert. Die Aufnahme schlägt fehl, nichts wird gespeichert.
- quarantine: Das Dokument wird mit Status
reviewbehalten, nie umgewandelt und nie indexiert. Spam allein führt nie zu einer Blockierung. - clean: Das Dokument wird indexiert.
Eine optionale zweite Meinung eines LLM über das Gateway (standardmäßig aus) wird nur eingeholt,
wenn die Regeln nicht blockiert haben; sie hat 15 Sekunden Zeit und lässt im Fehlerfall durch. Als
sicher bekanntes Material kann den Scan mit kb ingest --trusted überspringen. Bei der Ausgabe
umschließt /query jede Passage mit einer Markierung für nicht vertrauenswürdige Daten.
Abrufen. URL-Aufnahmen akzeptieren nur http und https, folgen höchstens fünf
Weiterleitungen und prüfen jede davon, und sie brechen bei 50 MB oder 180 Sekunden ab; eine
URL-Aufnahme liest nie eine lokale Datei. Zwei Standardwerte passen eher zu einem Laptop als zu
einem Server: Mit WEB_FETCH_ALLOW_PRIVATE=false lehnt kb Adressen ab, die zu privaten Netzwerken
auflösen (ein Schutz gegen Server-Side Request Forgery), und mit ALLOW_INSECURE_TLS=false
unterbleibt nach einem TLS-Fehler der erneute Versuch ohne Zertifikatsprüfung.
Personen. Die UI meldet Personen über pacod-id mit OIDC und PKCE an, auf den eigenen Seiten von pacod-id im Branding von kb. Sie prüft das Access-Token, hält die Tokens in einer verschlüsselten serverseitigen Sitzung und gibt dem Browser ein Cookie, das nur ein zufälliges Geheimnis trägt. Die Rollen von kb sind ein Manifest, das die UI bei jedem Start an pacod-id überträgt; die Rolle einer Person kommt dann aus dem Autorisierungs-Feed von pacod-id. Ohne kb-Rolle sieht eine Person eine Seite „kein Zugriff“; ist die Kopie des Feeds in der UI älter als 60 Sekunden, antworten die Seiten mit 503, statt zu raten. Die Abmeldung beendet die Sitzung bei pacod-id, und eine dort widerrufene Sitzung endet auch in kb.
| Rolle | Darf |
|---|---|
| viewer | Lesen und suchen |
| editor | Dokumente aufnehmen, neu indexieren und löschen; Jobs ausführen; Projekte verwalten |
| admin | AI Management, Prompts, die Laufzeitschalter, Mitglieder |
Admins laden auf der Mitgliederseite Personen ein und ändern Rollen, über die Admin-API von pacod-id: Aufgeführt werden nur die Rollen von kb, und der letzte Admin kann nicht entfernt werden.
Die Pipeline-API vergleicht ihren Schlüssel in konstanter Zeit und verweigert im Zweifel den
Zugriff: Ohne PIPELINE_API_SECRET antwortet jede Route außer /health mit 503.
Deployment und Betrieb
docker-compose.yml enthält die eigenen Dienste von kb, kb-pipeline und kb-ui.
docker-compose.standalone.yml enthält die Kopien der gemeinsamen Komponenten, die kb mitbringt,
eingeschaltet über Compose-Profile: Qdrant, PostgreSQL, pacod-id mit seiner Datenbank neben der von
kb, einen Mail-Catcher und ein Entwicklungs-Gateway, pacod-gw-lite vor den Mock-Anbietern von
pacod-gw, sodass nichts die Maschine verlässt. make up lädt beide Dateien; es braucht Checkouts
von pacod-id und pacod-gw neben dem von kb, und von jeder gemeinsamen Komponente kann auf einer
Maschine nur eine Kopie laufen. Der Mock gibt den Prompt als Echo zurück, deshalb lässt der
Entwicklungs-Stack die Umwandlung aus; AI Management → Test model durchläuft trotzdem den
ganzen Weg, Kosten eingeschlossen.
In Produktion verweist man kb auf ein echtes Gateway (pacod-gw mit einer Organisation, einem Workspace und einem Schlüssel für kb, oder pacod-gw-lite mit den Schlüsseln der Anbieter), stellt pacod-id hinter TLS oder nutzt ein bestehendes und lässt die Entwicklungsprofile weg.
pacod-demo, live unter demo.pacod.io,
betreibt kb zusammen mit den anderen pacod-Projekten. Es lädt nur die App-Datei von kb: kb legt
seine Datenbank im gemeinsamen PostgreSQL und seine kb_-Collections im gemeinsamen Qdrant ab,
bettet über den gemeinsamen Embeddings-Dienst ein und stellt seine UI hinter dem gemeinsamen
Caddy-Edge bereit. Auch die Demo lässt die Umwandlung aus.
- Speicher.
KB_STORAGE_BACKENDistfilesystemoderdatabase; ein Wechsel migriert keine Dokumente. - Daten. Die Datenverzeichnisse sind Variablen (
KB_ROOT,KB_MODEL_CACHE,KB_QDRANT_DATA,KB_POSTGRES_DATA). Ein Name ohne Schrägstrich ist ein Docker-Volume; unter macOS verwendetmake setupVolumes. - CPU.
TORCH_NUM_THREADS=0folgt der CPU-Quote des Containers.EMBED_BATCH_TOKENS(1024) begrenzt, wie lange eine Abfrage hinter einer Aufnahme warten kann. - Modelle offline. Einmal mit Netzwerkzugang laufen lassen, um den Modell-Cache zu füllen,
dann
HF_HUB_OFFLINE=1setzen. - Gemeinsame Modelle. Mit
EMBEDDINGS_URLbettet die Pipeline über den gemeinsamen Embeddings-Dienst ein, statt BGE-M3 selbst zu laden: Die Vektoren sind dieselben, es wird also nichts neu eingebettet, und die Pipeline braucht etwa 2 GB weniger Arbeitsspeicher.RERANKER_URLtut dasselbe für den Reranker. Wird das Modell dieses Dienstes je ersetzt, muss der Index von kb neu aufgebaut werden. - Gemeinsames Qdrant. Auf einem Qdrant, das auch andere Produkte nutzen, zeigen und berühren
die Qdrant-Seiten der UI nur die Collections von kb (
KB_QDRANT_COLLECTION_PREFIX, Standardkb_). - Laufzeitschalter. Das Dashboard schaltet Inhaltsscan, KI-Umwandlung und Sprachprüfung ohne Neustart ein und aus; sie werden nicht gespeichert, und beim nächsten Start gilt wieder die Umgebung.
- KI. Admins wählen Modelle und bearbeiten Prompts in AI Management, das auch die vom Gateway
gemeldete Nutzung und die Kosten zeigt. Jeder Aufruf trägt eine opake Zuordnung (Funktion, Job,
Projekt, Person); ein 429 wird einmal wiederholt, nach seinem
Retry-After. Ist kein Gateway konfiguriert, ist KI aus, und sonst geht nichts kaputt. - Logs. Ein Ereignis pro Zeile im gemeinsamen pacod-Format, JSON oder Text (
LOG_FORMAT), auf der StufeLOG_LEVEL, ohne Query-Strings. Docker behält fünf Dateien zu 10 MB pro Container.
Backups umfassen KB_ROOT oder die PostgreSQL-Datenbank von kb, den Qdrant-Speicher (oder man baut
ihn mit kb rebuild --all-projects neu auf), die Datenbank von pacod-id samt ihrem
Schlüsselverschlüsselungsschlüssel und .env.
Was getestet ist und wo die Grenzen liegen
make check führt ruff, mypy --strict und die Tests aus, die kein Netzwerk, keinen
Modell-Download und kein laufendes pacod-id oder Gateway brauchen: Die Tests der UI melden sich über
den echten Ablauf gegen ein nachgebildetes pacod-id an. Snapshots der Routentabellen beider APIs
fangen unbeabsichtigte Änderungen ab, und das CI führt bei jedem Push die Evaluierungssuite mit
einem Ersatz-Embedder aus, um Drift im Korpus oder im Chunker zu erkennen.
- Die Suchzahlen stammen von einem Entwicklungsrechner;
make eval-dockerwiederholt die Messung im Image der Pipeline, begrenzt auf eine vorgegebene Zahl von CPUs, wie auf dem Produktions-Host. - Pipeline und UI laufen jeweils mit einem einzigen Worker: Das eingebettete Qdrant hält eine Dateisperre, und die Sitzungsverwaltung der UI setzt einen Prozess voraus.
- Ein Reranker im eigenen Prozess der Pipeline verdoppelt ungefähr ihren Arbeitsspeicher; mit
RERANKER_URLlädt die Pipeline keinen. - Serbisch wird angenommen, aber die Spracherkennung hat kein serbisches Profil, sodass serbischer Text falsch erkannt oder abgelehnt werden kann.
- kb hat keinen Metrik-Endpunkt. Das Diagramm der KI-Nutzung lädt Chart.js von einem CDN, das einzige externe Skript der UI.
- Für die nächste Neuindexierung dokumentiert, nicht ausgeliefert: BGE-M3-Sparse-Vektoren für die Schlüsselworthälfte, Aufräumarbeiten am Chunker und der Neuaufbau in einer Schatten-Collection vor dem Umschalten.
Mehr dazu:
- Architektur: Container, Anmeldung, das Gateway, wer gehandelt hat.
- Metadatenvertrag: jedes Passagen- und Manifest-Feld.
- Retrieval-Evaluierung: die vollständigen Zahlen und die Entscheidungen hinter den Standardwerten.
- Runbook: Entwicklung, Produktion, Betrieb und Fehlersuche.
- Migrationen: das Upgrade einer
bestehenden Installation, einschließlich des Umzugs auf
pacod-netundpacod-admin-net.
Schnellstart
Mit Docker starten
make setup
make up
open http://localhost:8080/kb
Entwickeln und evaluieren
uv sync
make check
make eval
Funktioniert mit
- pacod-id: Personen melden sich über pacod-id an; die Rollen Viewer, Editor und Admin werden dort vergeben, und die Mitgliederseite von kb nutzt dessen Admin-API.
- pacod-gw: Der optionale LLM-Bereinigungsschritt und die optionale zweite Meinung des Scans laufen über das Gateway, das die Anbieterschlüssel hält, jeden Aufruf bepreist und zuordnet.
- pacod-ap: Läuft kb neben pacod-ap, kann es über dessen gemeinsamen Embeddings-Dienst einbetten und reranken, mit denselben BGE-M3-Vektoren.
- pacod-demo: Betreibt kb zusammen mit den anderen Produkten, auf dem gemeinsamen Qdrant, PostgreSQL und Embeddings-Dienst, hinter dem gemeinsamen Edge.