
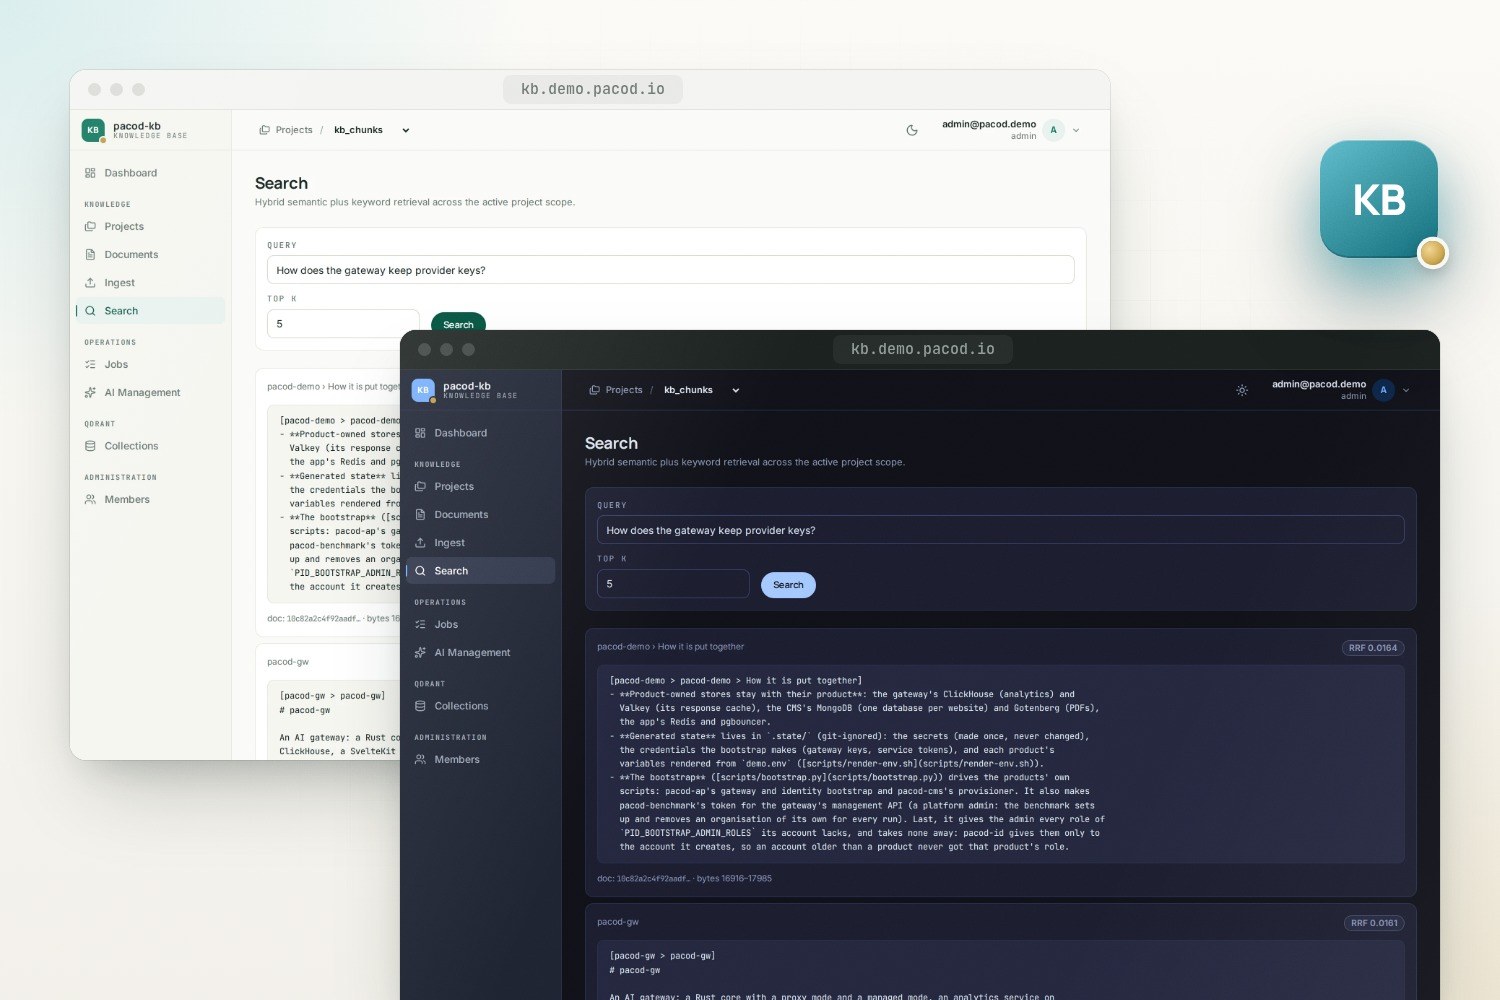
pacod-kb загружает файлы и веб-страницы, преобразует их в канонический Markdown, индексирует для гибридного семантического и ключевого поиска и хранит каждую версию. Каждый документ проверяется на prompt injection, прежде чем что-либо попадёт в индекс, а моделям ниже по цепочке kb передаёт фрагменты, на которые можно сослаться, по документированному контракту метаданных. Работает на CPU, и поиск остаётся отзывчивым, пока документы загружаются.
База знаний для RAG
- Лицензия: Apache-2.0
- Версия: 1.0.0 · Стабильная
- Языки: Python
- Технологии: FastAPI, HTMX, docling, BGE-M3, Qdrant, SQLite FTS5, PostgreSQL, Docker
- Открыть на GitHub · Создать issue
Возможности
Загрузка чего угодно
PDF, DOCX, HTML, Markdown, текст и JSON — загруженные вручную, положенные в папку, полученные по URL или отслеживаемые на изменения.
Канонический Markdown
Заголовки распознаются в юридических текстах на восьми языках, в научных работах и в статьях; номера страниц, колонтитулы и шаблонный текст отфильтровываются.
Безопасность контента
Многоуровневая проверка на prompt injection и спам блокирует документ или отправляет его в карантин до индексации; результаты поиска ограждаются как недоверенные данные.
Гибридный поиск
Плотные векторы BGE-M3 в Qdrant плюс индекс ключевых слов, объединённые методом reciprocal rank fusion, — в проектах, которые никогда не видят документов друг друга.
Все версии сохраняются
Новая версия замещает старую, а та остаётся доступной для поиска по дате; если отслеживаемая страница возвращается к прежнему виду, восстанавливается более ранняя версия.
Откалиброванная релевантность
Необязательный реранкер на cross-encoder выдаёт оценку релевантности от 0 до 1, сопоставимую между запросами, так что min_score может отсеивать результаты, которые не отвечают на вопрос.
Контракт для потребителей
Каждый фрагмент несёт стабильный идентификатор, свой путь по заголовкам и смещения в байтах в сохранённом Markdown, и каждое поле задокументировано.
Рассчитан на CPU
Запросы идут впереди работы по загрузке и ждут не больше одного небольшого пакета; эмбеддинги можно получать и от общего сервиса.
Веб-интерфейс и CLI
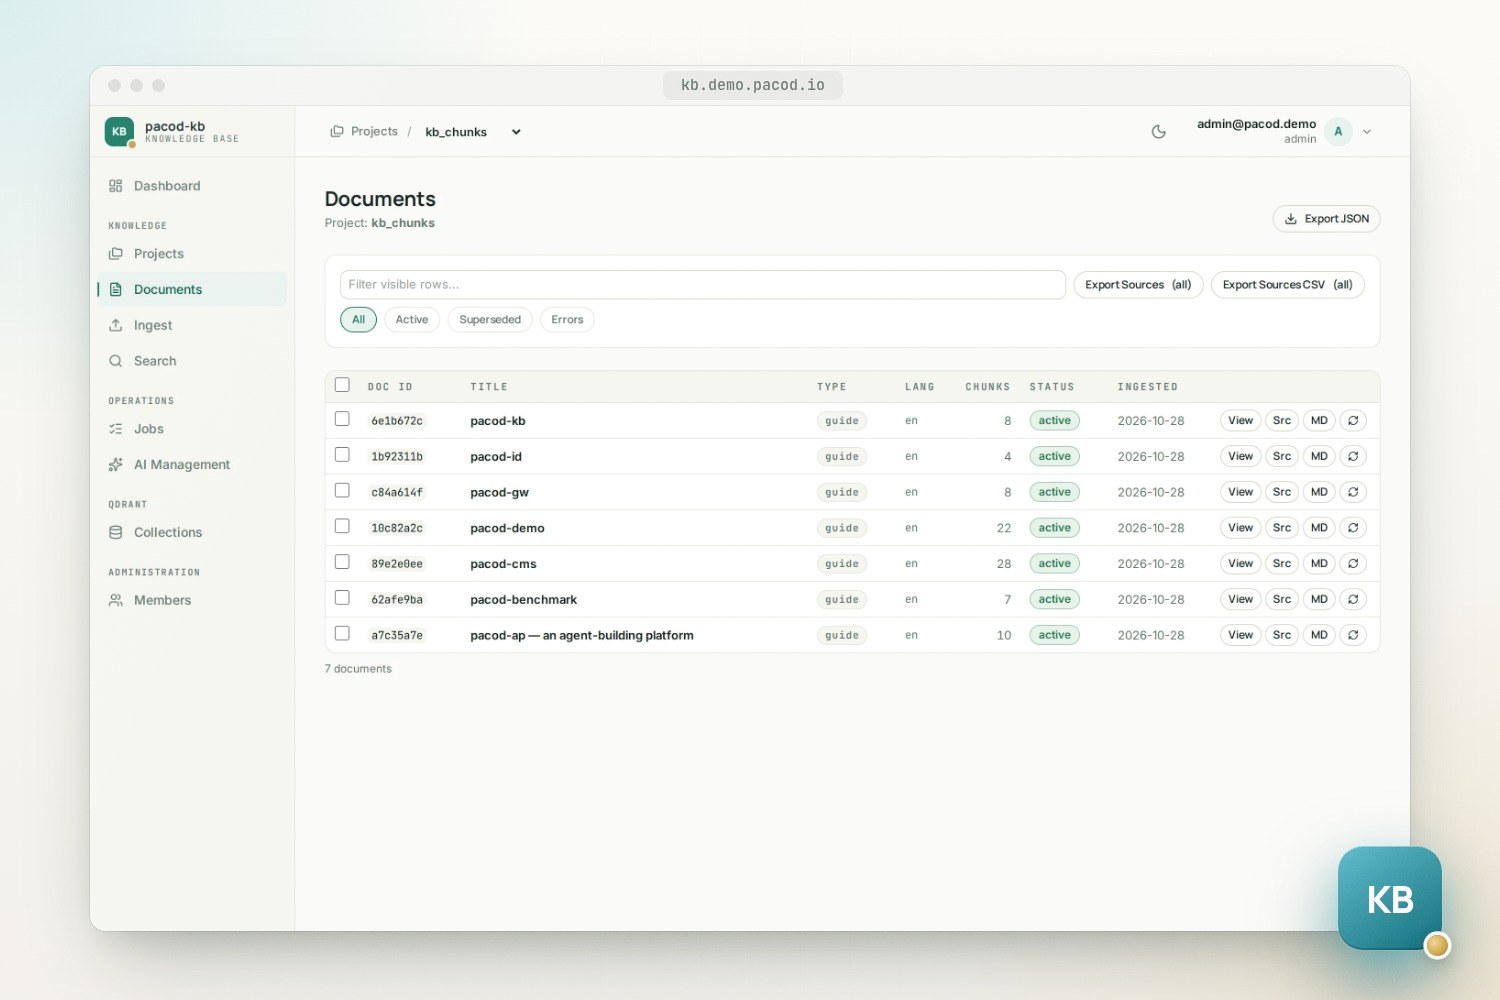
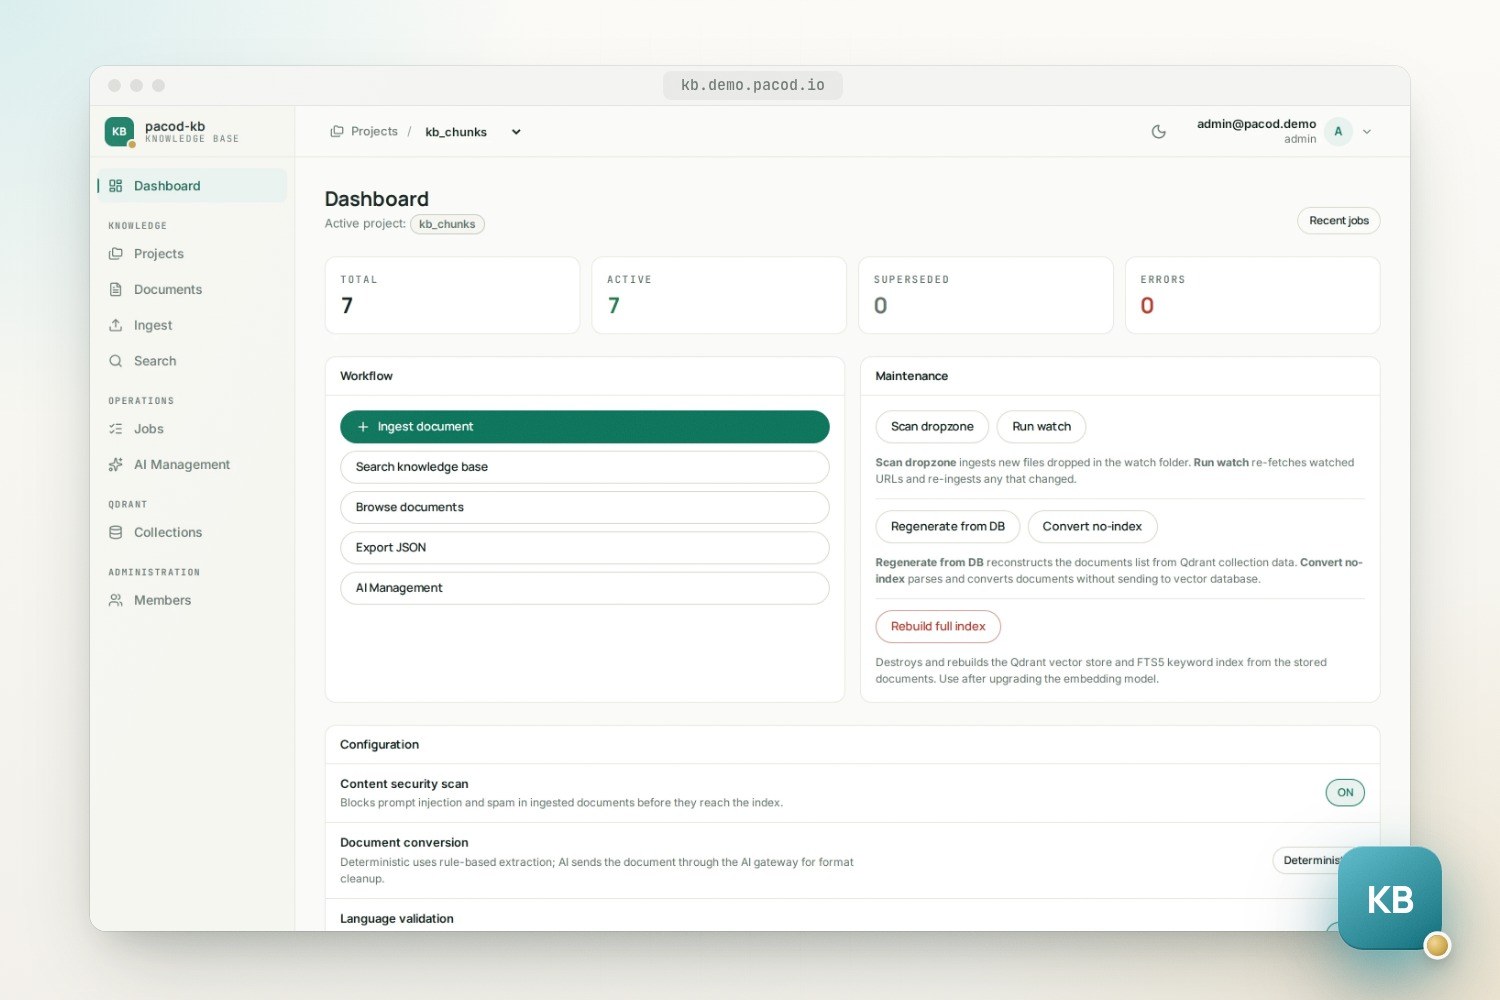
Веб-интерфейс в общем стиле pacod, светлый или тёмный, для документов, проектов, задач, использования AI и его стоимости и участников; CLI kb для загрузки, поиска, отслеживания, пересборки и экспорта.
Скриншоты
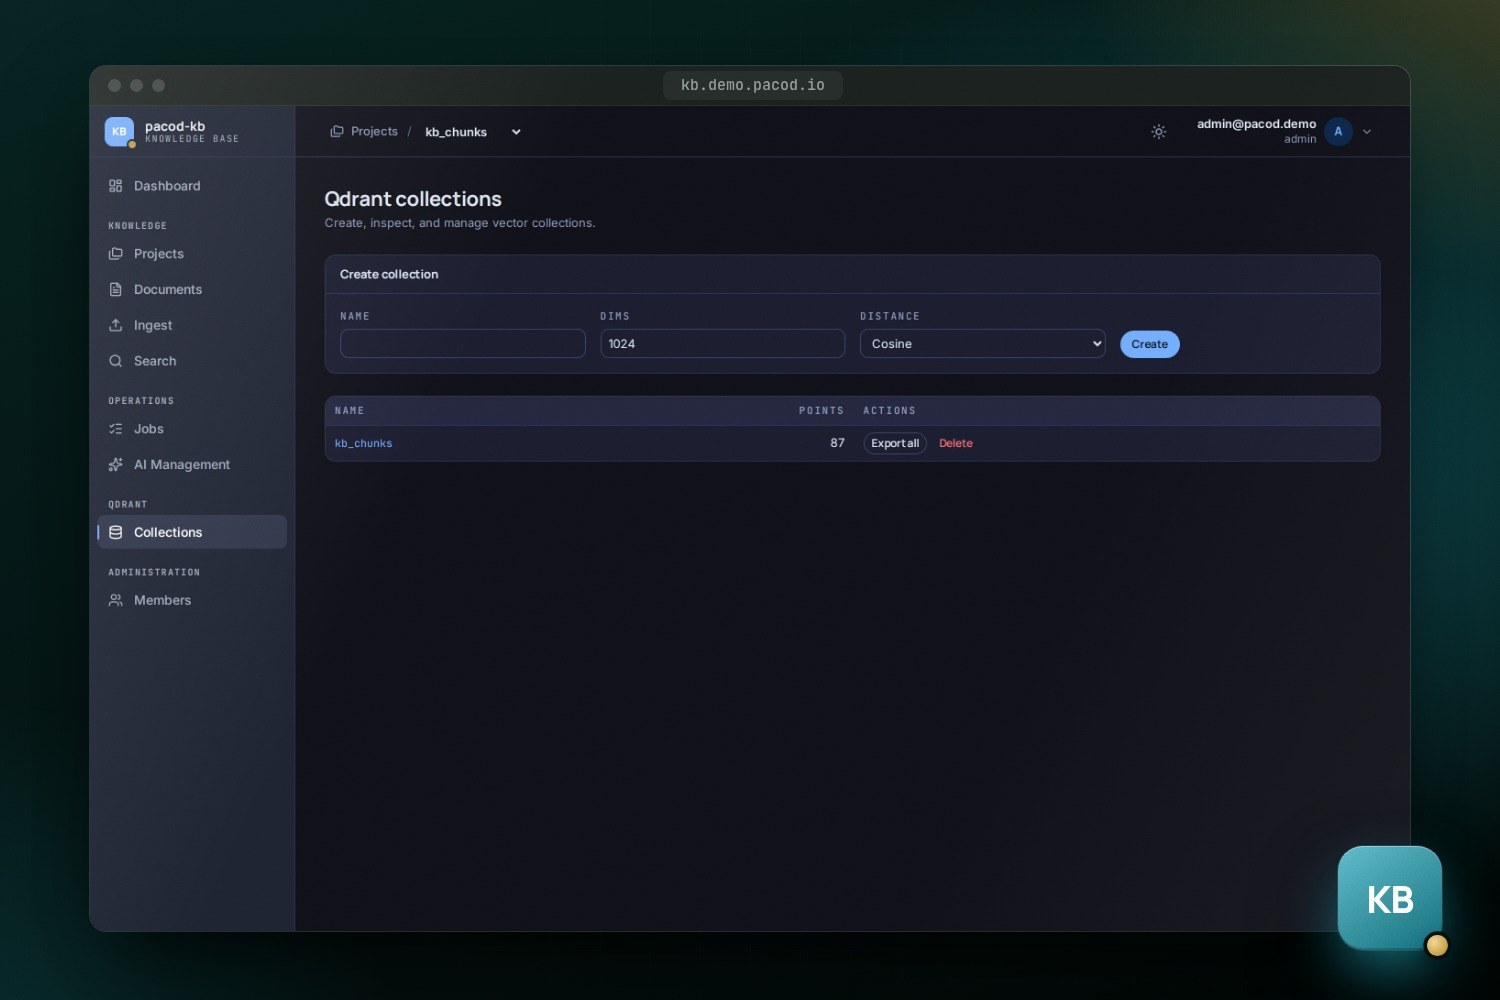
Зачем он нужен
Большая часть работы в retrieval-augmented generation происходит до того, как модель прочтёт хоть слово: загрузить документы, поддерживать их в чистоте, найти нужный фрагмент и сообщить модели, откуда он взят. pacod-kb — именно эта часть, выделенная в отдельный сервис с HTTP API, веб-интерфейсом и CLI.
Его сформировали три требования:
- Ответы должны быть цитируемыми. Каждый фрагмент несёт свой путь по заголовкам и смещения в байтах в стабильном тексте Markdown, так что потребитель может процитировать его, сослаться на него и получить его контекст.
- Источники меняются. Ничего не перезаписывается: новая версия замещает старую, а та остаётся доступной для поиска по дате.
- Загруженный текст — недоверенный ввод для модели. Перед индексацией он проверяется на prompt injection, а на выходе ограждается как данные.
Документ, шаг за шагом
Документ проходит один и тот же путь, был ли он загружен, положен в папку dropzone, получен по URL или повторно получен из отслеживаемого веб-источника:
- Приём. SHA-256 байтов источника — это идентификатор документа; уже известный идентификатор пропускается, поэтому один и тот же файл никогда не загружается дважды.
- Разбор. PDF через docling, с необязательным OCR для отсканированных страниц (если установлен tesseract, два движка сравниваются постранично), DOCX, HTML, Markdown, текст и JSON, ключи которого становятся заголовками. Результат — Markdown с front matter на YAML.
- Проверка языка. Принимаются английский, немецкий, болгарский, русский, сербский, македонский,
хорватский и словенский; другие языки отклоняются до того, как что-либо будет записано. Текст,
язык которого определить не удалось, принимается как
unknown, с предупреждением. - Сканирование детерминированного разбора на prompt injection и спам. Оно выполняется до того, как текст увидит какая-либо модель: преобразователь мог бы выполнить внедрённые инструкции, а преобразование удалило бы символы нулевой ширины и скрытую разметку, которые ищет проверка.
- Преобразование (необязательно). Проход LLM через pacod-gw приводит Markdown в порядок; PDF размером до 20 МиБ отправляется модели как файл, всё остальное — как извлечённый текст. Документ в карантине не отправляется никогда. Обрезанный, отказной или пустой ответ оставляет детерминированный разбор, а преобразованный текст проверяется второй раз.
- Очистка и структурирование. Фильтр шума убирает номера страниц, колонтитулы, уведомления о cookie и блоки навигационных ссылок. Заголовки повышаются в кодексах, регламентах и директивах (на восьми языках) и в научных работах; статья, полученная по URL, получает ещё автора, дату и издание.
- Сохранение
document.md, манифеста с журналом жизненного цикла и снимка источника — в папках подKB_ROOTили в PostgreSQL. - Индексация — только если статус документа
ok. Чанки до 500 токенов, учитывающие заголовки, встраиваются BGE-M3, каждый с цепочкой[Title > Heading > Subheading]в начале (таблица получает ещё и абзац перед ней), в коллекцию Qdrant и индекс ключевых слов проекта. Чанки, не изменившиеся с прежней версии, сохраняют свои векторы.
Загрузки из интерфейса или через API выполняются как задачи, одна за другой, на отдельном worker и никогда — в потоках, которые отвечают на поиск. В режиме базы данных задачи хранятся в PostgreSQL, а перезапуск помечает прерванные им задачи как завершившиеся ошибкой.
Архитектура
pacod-kb — это два сервиса, kb-pipeline и kb-ui, а также модели и хранилища, которыми они
пользуются:
| Часть | Роль |
|---|---|
Pipeline API (kb-pipeline, :8000) |
Загрузка, индексация, поиск, задачи, настройки; единственная часть, которая обращается к AI-шлюзу |
Веб-интерфейс (kb-ui, :8080) |
FastAPI и HTMX; вход через pacod-id, сессии, участники, страницы; обращается к конвейеру с API-ключом |
| BGE-M3 | Эмбеддинги размерности 1024 — в собственном процессе конвейера или от сервиса эмбеддингов pacod-ap |
| Qdrant | Векторы: встроенный в конвейер или отдельный сервер, которым могут пользоваться и другие продукты |
| Индекс ключевых слов | SQLite FTS5 (BM25) при хранении в файловой системе, полнотекстовый поиск PostgreSQL при хранении в базе данных |
| Документы и журнал учёта | Папки под KB_ROOT или PostgreSQL; журнал учёта хранит настройки, промпты, использование и стоимость AI |
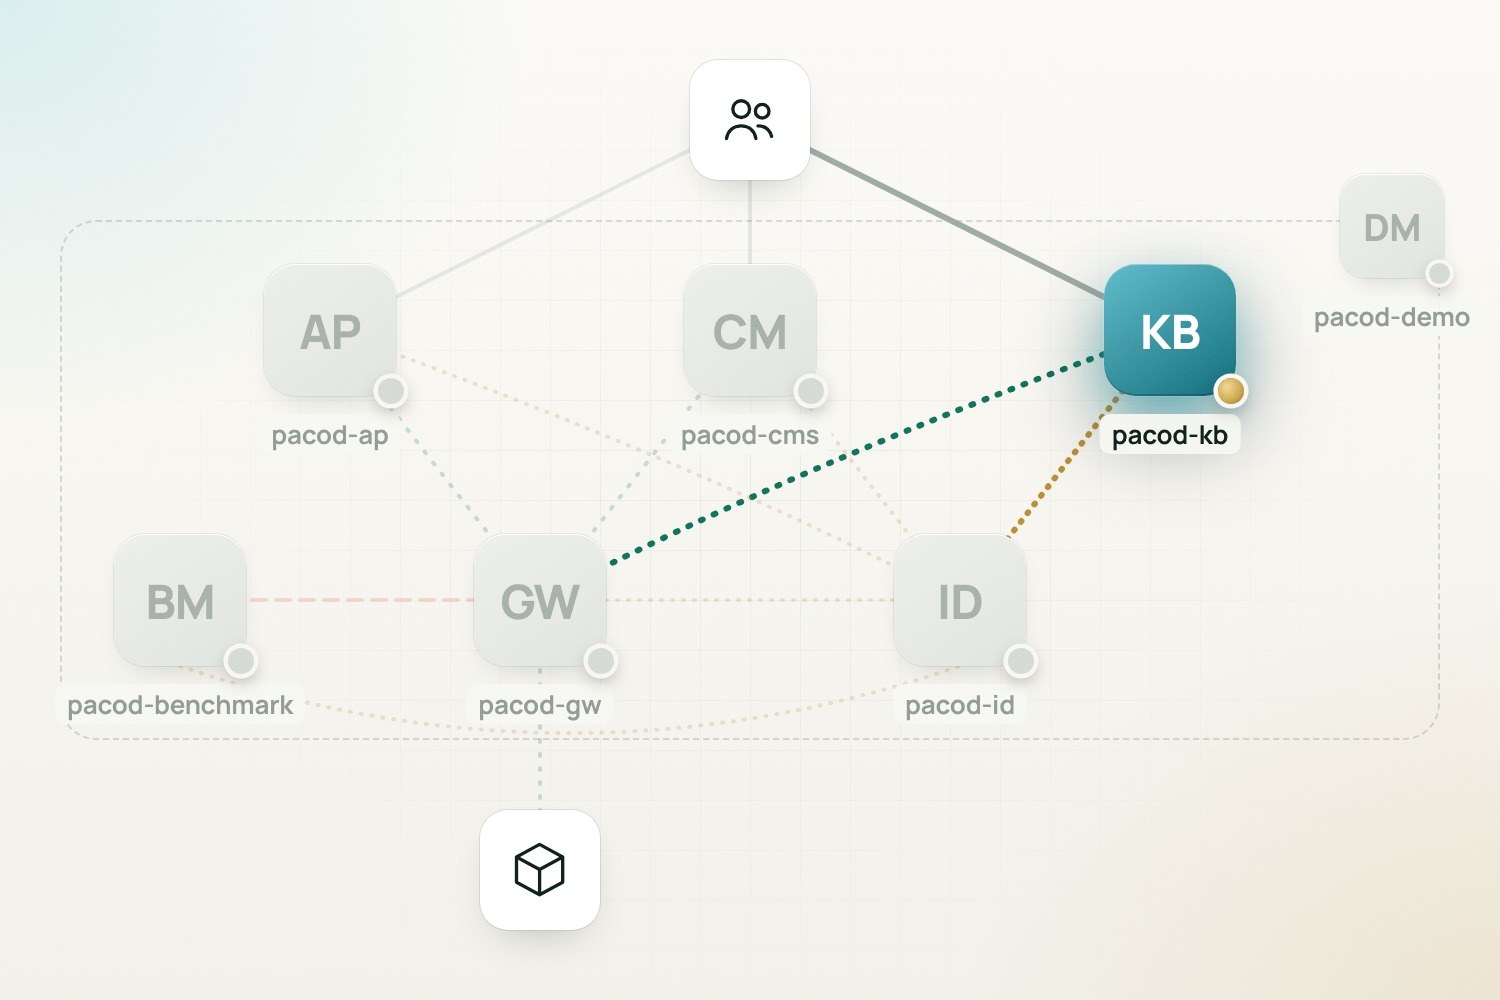
Такое разделение сделано намеренно. Конвейер разбирает недоверенные документы и загружает произвольные URL, поэтому не получает ни одного из секретов pacod-id; интерфейс никогда не видит ключ шлюза. Каждый контейнер получает явный список переменных окружения, и этот список проверяет тест.
Каждый контейнер подключается к общей сети Docker pacod-net, где все могут обращаться друг к
другу. Исключение — внутренний слушатель pacod-id (токены, ключи подписи, лента авторизации, admin
API): он отвечает только в pacod-admin-net, внутренней сети без выхода наружу, под именем
pacod-id-internal:8071. kb-ui подключён к этой сети; конвейер — нет, и обратиться к слушателю он
не может.
Кто что сделал. Каждый вызов из интерфейса несёт X-KB-Actor — идентификатор вошедшего
человека. Конвейер доверяет ему только вместе с API-ключом, записывает его в задачи, изменения
настроек и учёт использования и передаёт шлюзу. Когда pacod-id удаляет учётную запись, kb завершает
её сессии, повсюду заменяет этот идентификатор на deleted-user и только потом подтверждает
удаление.
Поиск и что получает модель
Запрос выполняется в Qdrant и в индексе ключевых слов, а два ранжирования объединяются методом reciprocal rank fusion: каждый список добавляет 1/(60 + ранг) за каждый найденный им фрагмент. Фильтры по дате и истории применяются внутри обоих поисков, так что сотня замещённых фрагментов не может вытеснить тот единственный, который действует.
Оценка RRF упорядочивает один список результатов и ничего не значит при сравнении разных запросов.
Оценка 0,0164 — это 1/61: первое место в одном списке и отсутствие в другом. Именно её по умолчанию
получает большинство вопросов, заданных естественным языком, потому что ключевая половина поиска
(KEYWORD_QUERY_MODE=legacy) требует совпадения каждого слова запроса. Режимы с анализом текста
(or, and_or) вместо этого отбрасывают стоп-слова и отсекают окончания; они остаются
выключенными, пока оценка не покажет, что они помогают.
Необязательный cross-encoder, BAAI/bge-reranker-v2-m3, переупорядочивает десять лучших кандидатов
и даёт каждому релевантность от 0 до 1, сопоставимую между запросами, так что min_score может
отсеивать результаты, которые не отвечают на вопрос. Он загружается в фоне, когда его включают, и
ни один запрос его не загружает.
POST /query принимает вопрос и его фильтры:
{"query": "maximum fine for a data breach", "top_k": 5, "as_of": "2025-12-30"}
Ответ — {"results": [...], "reranked": false, "score_kind": "rrf"}. Каждый результат
содержит:
| Поле | Для чего |
|---|---|
chunk_id |
Стабильный идентификатор, кодирующий структуру заголовков, а не порядковый номер |
source_id |
Идентификатор документа: SHA-256 байтов источника |
heading_path |
Цепочка заголовков вроде ["Chapter 1", "§ 5"] — для цитирования и фильтров по разделам |
byte_start, byte_end |
Смещения UTF-8 в сохранённом тексте Markdown |
valid_until |
Когда эта версия была замещена, или null, пока она актуальна |
text |
Текст, по которому построен эмбеддинг, ограждённый как недоверенные данные |
score, rrf_score, rerank_score |
Оценка для упорядочивания и её составляющие |
Смещения считаются в байтах, а не в символах, что важно для кириллицы:
body_bytes = body.encode("utf-8")
passage = body_bytes[result["byte_start"]:result["byte_end"]].decode("utf-8")
У каждого документа есть и манифест: заголовок, источник, тип документа, статус, проект, парсер или
модель шлюза, создавшие текст, и журнал жизненного цикла (ingested, superseded,
reinstated, security_flagged, review_flagged, llm_usage).
Версии и проекты
Новая версия, загруженная с --supersedes, или изменившийся отслеживаемый источник помечает
старую версию полем valid_until — сразу в четырёх местах: во front matter, в манифесте, в индексе
ключевых слов и в данных векторов. Поиск по умолчанию возвращает актуальные фрагменты; as_of —
то, что действовало в заданный день; include_historical — всё. Если отслеживаемая страница
вернулась к прежнему виду, более ранняя версия восстанавливается. В режиме файловой системы с
GIT_AUTOCOMMIT=true каждая загрузка также фиксируется коммитом в git-репозитории в KB_ROOT.
Проект — это изолированная коллекция: собственная коллекция Qdrant и собственные строки в
индексе ключевых слов. Поиск видит один проект, пересборка удаляет и заново заполняет индекс одного
проекта (--all-projects пересобирает каждый в его собственную коллекцию), а переключение
активного проекта отклоняется, пока задача стоит в очереди или выполняется.
Поиск, подтверждённый измерениями
Значения по умолчанию получены на стенде оценки поиска: 14 документов на шести языках (GDPR, Директива о защите данных в правоохранительной сфере, четыре конституции, статьи Википедии) и 92 написанных вручную запроса — перефразировки, точные термины, межъязыковые, на родном языке и без ответа. Результат засчитывается, если он взят из размеченного раздела, поэтому разметка переживает изменения в разбиении на чанки. Цифры измерены на процессоре машины разработчика (Apple M5, четыре потока), и документация подчёркивает, что это не продакшен-цифры:
| Показатель | Результат |
|---|---|
| Нужный раздел среди объединённых кандидатов | для каждого запроса, у которого есть ответ |
| Нужный раздел в первой пятёрке, без реранкера | 98,7 % (R@1 0,83, около 50 мс) |
| С реранкером, десять кандидатов | R@1 0,91, около 2 с на запрос |
| Поиск во время загрузки документов (p50) | раньше 24,3 с; теперь 0,41 с, когда задачи выполняются одна за другой |
| Встраивание при загрузке, пакеты, отсортированные по длине | примерно в 2,2 раза быстрее, векторы не меняются |
Оценка реранкера отличает ответы от того, что ответом не является: min_score 0.1 отсеивает 14 из
15 запросов без ответа и 2 из 70 правильных первых ответов, тогда как по оценкам RRF их было вообще
не различить. Тем не менее по умолчанию он выключен: его выигрыш немного не дотянул до порога на
отложенной половине запросов, а его задержку ещё нужно подтвердить на продакшен-процессоре.
Режимы ключевого поиска с анализом текста помогли запросам на родном языке и с точными терминами,
но на межъязыковых и перефразированных запросах потеряли больше и проиграли на отложенной
половине: legacy остаётся значением по умолчанию.
Модель безопасности
Безопасность содержимого. Проверка работает с нормализованной копией текста (нормализация Unicode, приведение к нижнему регистру, склеивание слов, набранных вразрядку) и применяет таблицы правил: фразы-инъекции на английском, немецком, русском и болгарском, трюки с переопределением направления текста и символами нулевой ширины, блоки base64 и hex (они декодируются и проверяются ещё раз), скрытую разметку и признаки спама, такие как плотность ссылок и повторяющиеся строки. У каждого правила своя серьёзность. Высокая серьёзность — только у однозначной подмены инструкций («ignore previous instructions»), символа смены направления текста и инструкции, спрятанной в base64; фразы, которые встречаются и в технических текстах, например «enable developer mode», имеют низкую серьёзность, так что одно совпадение не может заблокировать документ. Тесты проверяют, что длинные законы, в том числе GDPR, проходят как чистые. Вердикт — один из трёх:
- block: находка высокой серьёзности или высокий показатель угрозы. Загрузка завершается ошибкой, и ничего не сохраняется.
- quarantine: документ сохраняется со статусом
review, никогда не преобразуется и никогда не индексируется. Один только спам никогда не приводит к блокировке. - clean: документ индексируется.
Необязательное второе мнение LLM через шлюз (по умолчанию выключено) запрашивается, только если
правила не заблокировали документ; на него отводится 15 секунд, и при сбое оно не блокирует
документ. Заведомо безопасный материал может обойти проверку с kb ingest --trusted. На выходе
/query заключает каждый фрагмент в ограждение для недоверенных данных.
Загрузка по URL. Принимаются только http и https; допускается не больше пяти
перенаправлений, и каждый переход проверяется; загрузка останавливается на 50 МБ или через
180 секунд. Загрузка по URL никогда не читает локальный файл. Два значения по умолчанию подходят
для ноутбука, а не для сервера: задайте WEB_FETCH_ALLOW_PRIVATE=false, чтобы отклонять адреса,
которые разрешаются в частные сети (защита от server-side request forgery), и
ALLOW_INSECURE_TLS=false, чтобы после ошибки TLS не выполнялся повторный запрос без проверки
сертификата.
Люди. Интерфейс выполняет вход через pacod-id по OIDC с PKCE, на собственных страницах pacod-id в оформлении kb. Он проверяет токен доступа, хранит токены в зашифрованной серверной сессии и выдаёт браузеру cookie, в котором есть только случайный секрет. Роли kb — это манифест, который интерфейс передаёт в pacod-id при каждом запуске; роль человека затем берётся из ленты авторизации pacod-id. Без роли в kb человек видит страницу «нет доступа»; если копия ленты в интерфейсе старше 60 секунд, страницы отвечают 503, а не гадают. Выход завершает сессию в pacod-id, а сессия, отозванная там, завершается и в kb.
| Роль | Может |
|---|---|
| viewer | Читать и искать |
| editor | Загружать, переиндексировать и удалять документы; запускать задачи; управлять проектами |
| admin | AI Management, промпты, переключатели во время работы, участники |
Администраторы приглашают людей и меняют роли на странице участников через admin API pacod-id: в списке только роли kb, а последнего администратора удалить нельзя.
API конвейера сравнивает свой ключ за постоянное время и по умолчанию закрыт: без
PIPELINE_API_SECRET каждый маршрут, кроме /health, отвечает 503.
Развёртывание и эксплуатация
docker-compose.yml содержит собственные сервисы kb, kb-pipeline и kb-ui.
docker-compose.standalone.yml содержит копии общих компонентов для kb, которые включаются
профилями Compose: Qdrant, PostgreSQL, pacod-id с базой данных рядом с базой kb, перехватчик почты
и шлюз для разработки — pacod-gw-lite перед mock-провайдерами pacod-gw, так что ничего не покидает
машину. make up загружает оба файла; для этого рядом с kb нужны клоны pacod-id и pacod-gw, а на
одной машине может работать только одна копия каждого общего компонента. Mock-провайдер отвечает
эхом промпта, поэтому стек разработки оставляет преобразование выключенным;
AI Management → Test model всё равно проходит весь путь, включая стоимость.
В продакшене kb направляют на настоящий шлюз (pacod-gw с организацией, рабочим пространством и ключом для kb или pacod-gw-lite с ключами провайдеров), ставят pacod-id за TLS или используют уже существующий и убирают профили для разработки.
pacod-demo, работающий на demo.pacod.io,
запускает kb вместе с остальными проектами pacod. Он загружает только файл приложения kb: kb
хранит свою базу данных в общем PostgreSQL, а свои коллекции kb_ — в общем Qdrant, строит
эмбеддинги через общий сервис эмбеддингов, а его интерфейс обслуживается за общим входным Caddy.
Демо тоже оставляет преобразование выключенным.
- Хранилище.
KB_STORAGE_BACKEND—filesystemилиdatabase; переключение не переносит документы. - Данные. Каталоги данных задаются переменными (
KB_ROOT,KB_MODEL_CACHE,KB_QDRANT_DATA,KB_POSTGRES_DATA). Имя без косой черты означает том Docker; на macOSmake setupиспользует тома. - Процессор.
TORCH_NUM_THREADS=0следует квоте процессора контейнера.EMBED_BATCH_TOKENS(1024) ограничивает, сколько запрос может ждать за загрузкой. - Модели офлайн. Запустите один раз с доступом к сети, чтобы заполнить кэш моделей, затем
задайте
HF_HUB_OFFLINE=1. - Общие модели. С
EMBEDDINGS_URLконвейер строит эмбеддинги через общий сервис эмбеддингов, а не загружает BGE-M3 сам: векторы те же, поэтому ничего не нужно встраивать заново, а конвейеру требуется примерно на 2 ГБ меньше памяти.RERANKER_URLделает то же самое для реранкера. Если модель этого сервиса когда-нибудь заменят, индекс kb придётся пересобрать. - Общий Qdrant. На Qdrant, которым пользуются и другие продукты, страницы Qdrant в интерфейсе
показывают и затрагивают только коллекции kb (
KB_QDRANT_COLLECTION_PREFIX, по умолчаниюkb_). - Переключатели во время работы. Панель включает и выключает проверку содержимого, AI-преобразование и проверку языка без перезапуска; эти настройки не сохраняются, и при следующем запуске снова действуют переменные окружения.
- AI. Администраторы выбирают модели и правят промпты в AI Management, где также видно
использование и стоимость, о которых сообщил шлюз. Каждый вызов несёт непрозрачную атрибуцию
(функция, задача, проект, человек); ответ 429 повторяется один раз, после его
Retry-After. Если шлюз не настроен, AI выключен, а всё остальное работает. - Логи. Одно событие на строку в общем формате pacod, JSON или текст (
LOG_FORMAT), на уровнеLOG_LEVEL, без строк запроса в URL. Docker хранит пять файлов по 10 МБ на контейнер.
Резервные копии охватывают KB_ROOT или базу данных kb в PostgreSQL, хранилище Qdrant (или его
можно пересобрать командой kb rebuild --all-projects), базу данных pacod-id вместе с её ключом
шифрования ключей и .env.
Что проверено и ограничения
make check запускает ruff, mypy --strict и тесты, которым не нужны ни сеть, ни загрузка
моделей, ни работающий pacod-id или шлюз: тесты интерфейса проходят вход по настоящему сценарию
против поддельного pacod-id. Снимки таблиц маршрутов обоих API ловят непреднамеренные изменения, а
CI при каждом push запускает набор оценки с эмбеддером-заглушкой, чтобы поймать дрейф в корпусе или
в разбиении на чанки.
- Цифры поиска получены на одной машине разработчика;
make eval-dockerповторяет их внутри образа конвейера с ограничением до заданного числа CPU, как на продакшен-хосте. - Конвейер и интерфейс работают с одним worker каждый: встроенный Qdrant держит блокировку файла, а работа интерфейса с сессиями рассчитана на один процесс.
- Реранкер в собственном процессе конвейера примерно удваивает потребление им памяти; с
RERANKER_URLконвейер не загружает реранкер вовсе. - Сербский принимается, но у детектора языка нет профиля для сербского, поэтому сербский текст может быть определён неверно или отклонён.
- У kb нет эндпоинта метрик. График использования AI загружает Chart.js из CDN — это единственный внешний скрипт интерфейса.
- Задокументировано для следующей переиндексации, но не выпущено: разреженные векторы BGE-M3 для ключевой половины поиска, доработка разбиения на чанки и пересборка в теневую коллекцию с последующим переключением.
Подробнее:
- Архитектура: контейнеры, вход, шлюз, кто что сделал.
- Контракт метаданных: каждое поле фрагмента и манифеста.
- Оценка поиска: полные цифры и решения, стоящие за значениями по умолчанию.
- Руководство по эксплуатации: разработка, продакшен, эксплуатация и устранение неполадок.
- Миграции: обновление
существующей установки, включая переход на
pacod-netиpacod-admin-net.
Быстрый старт
Запуск в Docker
make setup
make up
open http://localhost:8080/kb
Разработка и оценка
uv sync
make check
make eval
Работает с
- pacod-id: Пользователи входят через pacod-id; роли viewer, editor и admin назначаются там, а страница участников kb работает через его admin API.
- pacod-gw: Необязательный проход очистки через LLM и необязательное второе мнение при проверке идут через шлюз, который хранит ключи провайдеров, рассчитывает стоимость каждого вызова и атрибутирует его.
- pacod-ap: Работая рядом с pacod-ap, kb может строить эмбеддинги и переранжировать через его общий сервис эмбеддингов — с теми же векторами BGE-M3.
- pacod-demo: Запускает kb вместе с остальными продуктами на общих Qdrant, PostgreSQL и сервисе эмбеддингов, за общей точкой входа.