
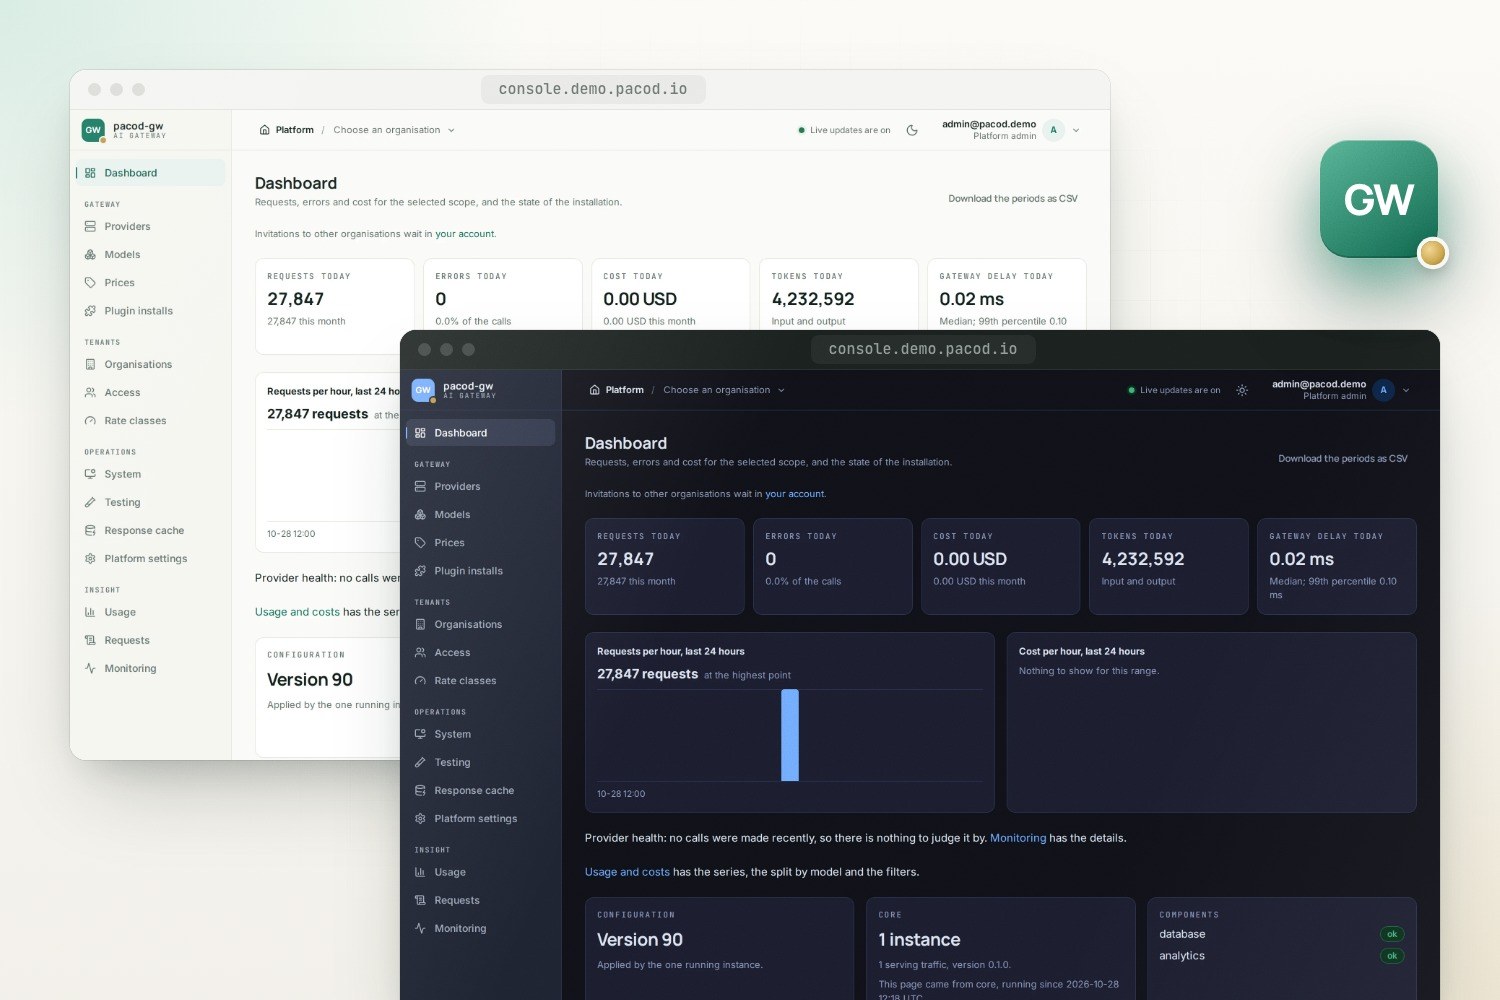
pacod-gw sitzt zwischen deinen Anwendungen und den LLM-Anbietern. Ein Rust-Kern leitet jeden Aufruf weiter oder übersetzt ihn, hält Anbieterschlüssel aus deinen Apps heraus, setzt Limits durch, bepreist jede Anfrage und kann einen wiederholten Aufruf aus seinem Cache beantworten. Die Nutzungsdaten fließen in ClickHouse-Analysen, und verwaltet wird alles über eine SvelteKit-Konsole.
KI-Gateway
- Lizenz: Apache-2.0
- Version: 0.1.0 · Vorschau
- Geschrieben in: Rust, TypeScript, Python
- Tech-Stack: Rust, PostgreSQL, ClickHouse, Valkey, SvelteKit, Caddy, Docker, Helm, Prometheus, OpenTelemetry
- Auf GitHub ansehen · Issue eröffnen
Funktionen
Proxy oder Managed
Die API eines Anbieters Byte für Byte weiterleiten, WebSocket-Sitzungen eingeschlossen — oder das Gateway Templates auflösen, Parameter steuern und zwischen Dialekten übersetzen lassen.
Viele Dialekte, ein Vertrag
OpenAIs Chat Completions und Responses, Anthropics Messages, Geminis generateContent und eine native Schnittstelle, dazu Embeddings, Bilder, Sprachausgabe, Transkription, Rerank und Realtime.
Schlüssel bleiben im Gateway
Anbieter-Zugangsdaten, versiegelt für die Installation, eine Organisation oder einen Workspace, und Gateway-Schlüssel pro Workspace. Anwendungen sehen nie den Schlüssel eines Anbieters.
Limits vor dem Aufruf
Token-, Anfrage- und Ausgabenlimits pro Organisation, Workspace, Schlüssel und Endnutzer, geprüft, bevor ein Aufruf das Gateway verlässt.
Jeder Aufruf bepreist
Ein versionierter Preis pro Modell, mit Sätzen für Cache und Reasoning. Eine Managed-Antwort kann ihre Kosten mitbringen, und jeder Aufruf hat sie im Anfrageprotokoll.
Antwort-Cache
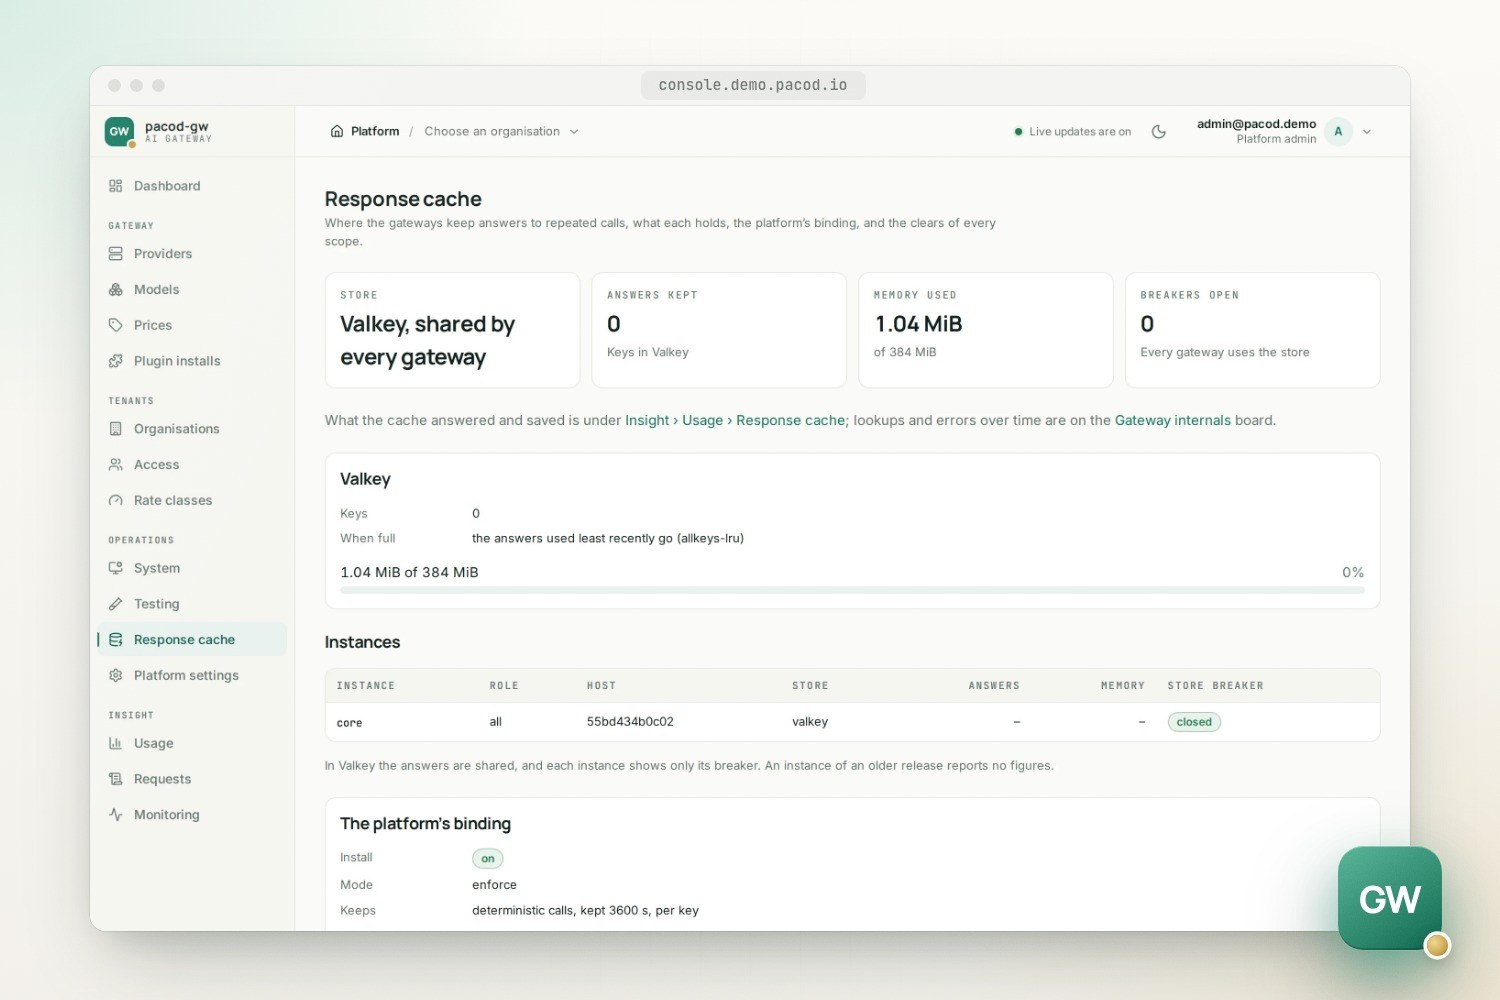
Ein wiederholter Aufruf mit Temperatur 0 wird aus einem Cache beantwortet, standardmäßig pro API-Schlüssel und in Valkey versiegelt. Ein Treffer kostet nichts und zählt gegen kein Limit. In einer neuen Installation aus, bis man ihn einschaltet.
Analysen auf ClickHouse
Events fließen in einen eigenen Analysedienst mit Reports und geplanten Jobs; Prometheus, Grafana und OpenTelemetry für den Betrieb.
Routing und Intent
Routing-Schemata mit Regeln, Failover über Dialekte hinweg und ein Circuit Breaker, dazu ein Intent-Plugin mit LLM-, Jev- und Kaskaden-Engine, das einen Aufruf danach blockieren, routen oder anrechnen kann, wofür er gedacht ist.
Lite-Modus
Dieselbe Data Plane in einem Container — ohne Datenbank, ohne Konsole —, konfiguriert über eine einzige .env-Datei und mit einer Logzeile samt Kosten für jeden Aufruf.
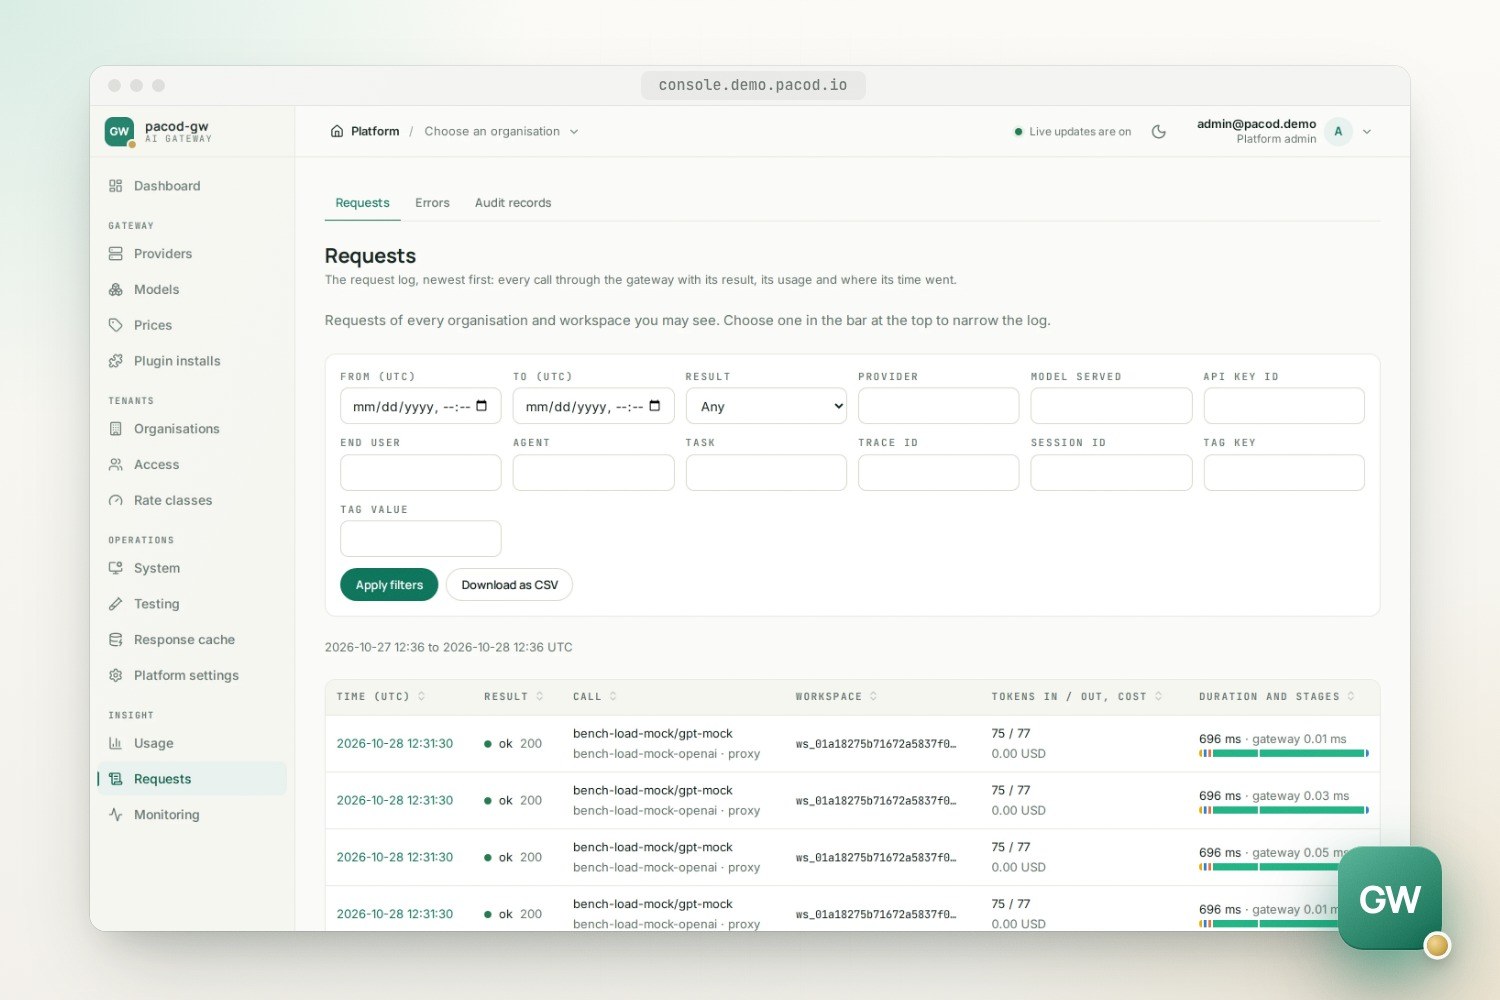
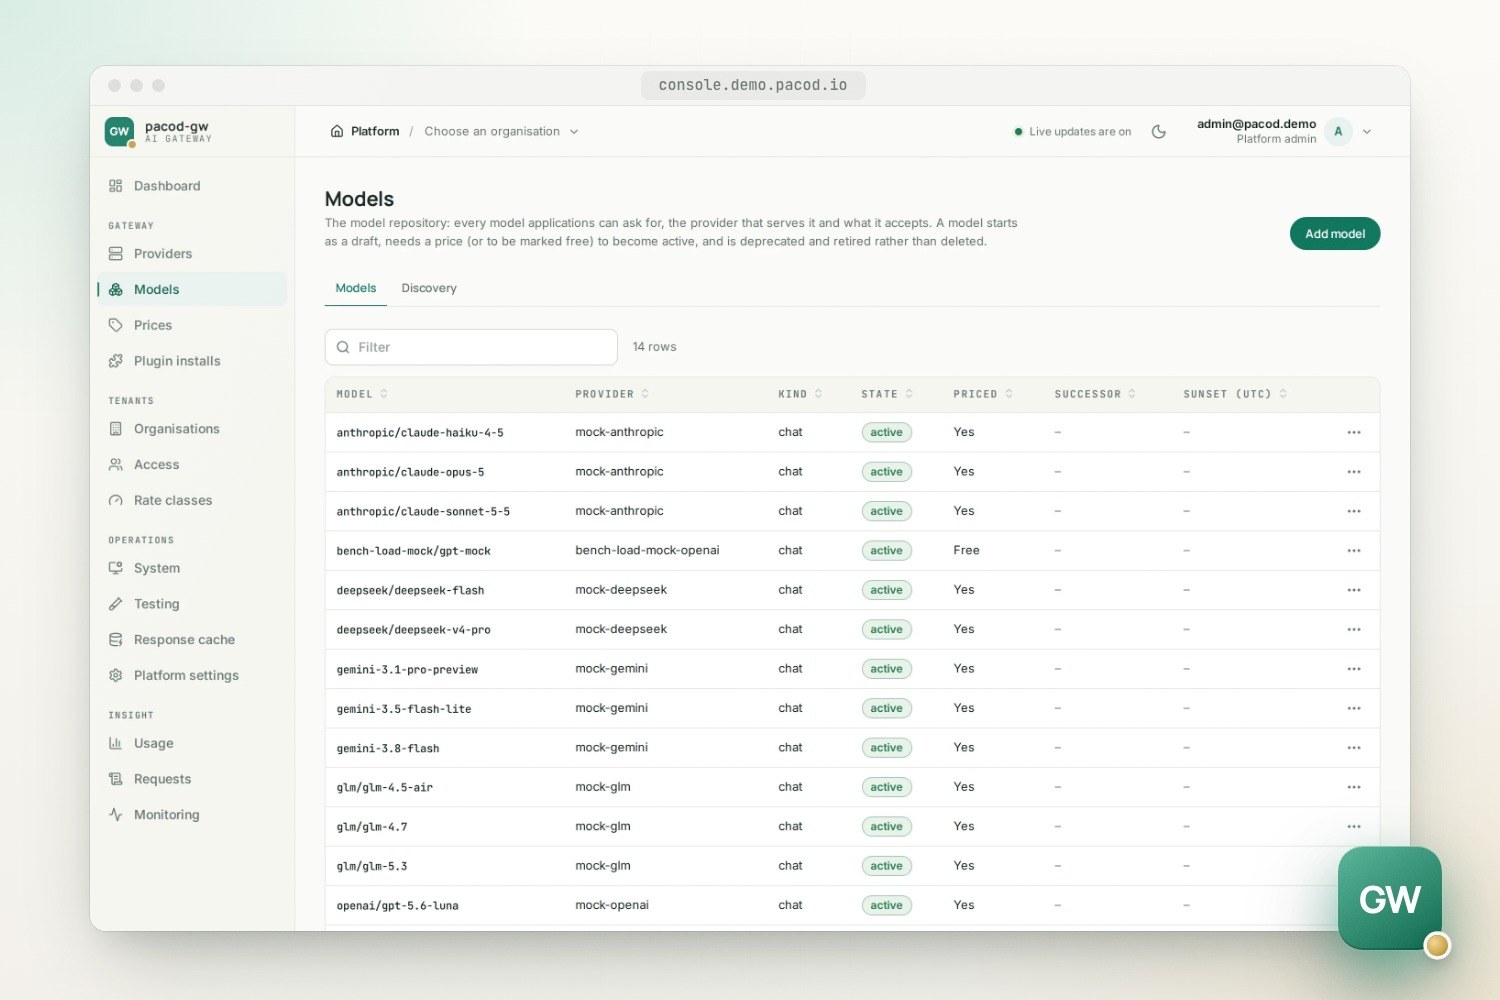
Screenshots
Warum ein Gateway
Jedes Produkt, das mit einem Sprachmodell spricht, implementiert am Ende dieselben Dinge neu: Anbieterschlüssel speichern, zwischen APIs übersetzen, Tokens zählen, Limits durchsetzen und die Rechnung erklären. pacod-gw nimmt all das aus der Anwendung heraus. Die Anwendung ruft einen Endpunkt mit einem Gateway-Schlüssel auf; das Gateway entscheidet, welches Modell den Aufruf bedient, was er kosten darf und wer ihn bezahlt.
Das erste Ziel ist konkret: einen LiteLLM-Proxy vor einer Anwendung ersetzen, indem nur deren Basis-URL und Schlüssel geändert werden.
Zwei Modi, ein Kern
Der Kern ist ein Rust-Binary mit zwei Listenern: der Data Plane für Anwendungen und der Management-API für die Konsole und Skripte. Der Modus wird über das URL-Präfix gewählt und pro Schlüssel erlaubt.
- Proxy-Modus (
/proxy/{provider}/…) leitet die API des Anbieters Byte für Byte weiter, WebSocket-Sitzungen eingeschlossen, und ergänzt Authentifizierung, Limits und Abrechnung. Ein Template kann trotzdem das Modell und seine Parameter setzen. - Managed-Modus bedient OpenAIs
/v1/chat/completionsund/v1/responses, Anthropics/v1/messages, GeminisgenerateContentund das native/gw/v1/chat. Neben Chat bedient er Embeddings, Sprachausgabe, Transkription und Übersetzung von Audio, Erzeugen und Bearbeiten von Bildern, Rerank in Coheres Form (bei Cohere, Jina, Voyage und vLLM), OpenAIs Realtime-Sitzungen über WebSocket sowie die Files- und Batches-APIs von OpenAI und Anthropic.
Im Managed-Modus bestimmen der Dialekt des Aufrufers und der Anbieter des Modells den Weg:
| Aufrufer spricht | Modell liegt bei | Was passiert |
|---|---|---|
| OpenAI-Dialekt | einem OpenAI-kompatiblen Anbieter (OpenAI, DeepSeek, GLM, Kimi, Ollama, …) | Die Bytes des Aufrufers werden gepatcht; die Kosten kommen in usage hinzu. |
| Anthropic-Dialekt | Anthropic | Die Konversation erreicht Anthropic so, wie sie gesendet wurde; die Kosten kommen in einem Header zurück. |
| OpenAIs Responses-API | OpenAI oder xAI | Die Bytes des Aufrufers werden gepatcht, immer mit store: false; die Kosten kommen in usage hinzu. |
| Jede andere Kombination und die native Schnittstelle | jedem Anbieter | Übersetzt über ein anbieterneutrales Modell und zurück, sodass ein Aufruf über Dialekte hinweg ausweichen kann. |
Gespeicherte Antworten. OpenAIs Responses-API kann eine Antwort aufbewahren, sodass der nächste
Aufruf sie nur noch nennt. Das Gateway lässt nie einen Anbieter eine aufbewahren: Ein Zugang, den
mehrere Workspaces teilen, ließe jeden die Antworten der anderen lesen. Schaltet ein Workspace
responses.store ein, bewahrt das Gateway seine Antworten selbst auf, in PostgreSQL, standardmäßig
30 Tage, und schickt die früheren Runden beim nächsten Aufruf erneut mit. Eine Konversation kann so
zwischen Anbietern wandern: Eine Runde, die Claude beantwortet hat, lässt sich bei OpenAI fortsetzen
und umgekehrt. OpenAIs Conversations-API (/v1/conversations) wird ebenso aufbewahrt.
Ein Aufruf, Schritt für Schritt
- Authentifizieren. Der Schlüssel wird per HMAC in einem In-Memory-Snapshot der Konfiguration nachgeschlagen.
- Lesen. Ein Scanner findet Modell und Stream-Flags, ohne den ganzen Body zu parsen. Ein Aufruf, der eine gespeicherte Antwort fortsetzt, erhält seine früheren Runden; die Plugins des Workspaces sehen die Konversation.
- Auflösen. Ein Template (
@nameoderx-gw-template) oder eine freigegebene Modell-ID bestimmt das Modell und seine Parameter. - Nachschlagen. Ist der Antwort-Cache an, wird im Managed-Modus eine aufbewahrte Antwort auf dieselbe Anfrage hier zurückgegeben, im Dialekt des Aufrufers, bevor der Aufruf einen Slot belegt oder auf ein Limit angerechnet wird.
- Zulassen. Das Parallelitätslimit des Schlüssels und jedes anwendbare Limit müssen passen.
- Senden. Die gespeicherten Anbieter-Zugangsdaten ersetzen den Gateway-Schlüssel. Im Managed-Modus werden ein 429, ein 5xx oder eine verlorene Verbindung wiederholt oder an das nächste Modell weitergereicht, bevor der Aufrufer ein Byte erhält.
- Weiterleiten und abrechnen. Die Antwort streamt zurück, während ein Abgriff die Nutzung aus einer Kopie liest; danach werden Kosten und Zähler aktualisiert, die Antwort wird aufbewahrt, wenn der Cache sie nimmt, und ein Usage-Event geht in einen Spool auf der Festplatte.
Die Antwort enthält x-gw-request-id, x-gw-delay-ms (die Zeit, die das Gateway selbst
hinzugefügt hat), x-gw-model-served, x-gw-route, wenn ein Routing-Schema das Modell gewählt
hat, x-gw-cache, wenn der Cache den Aufruf angesehen hat, und bei nicht gestreamten
Managed-Aufrufen x-gw-cost.
Die Konfiguration liegt in PostgreSQL, aber der Anfragepfad wartet nicht darauf: Eine Änderung tauscht innerhalb von etwa zwei Sekunden einen neuen Snapshot ein, und fällt die Datenbank aus, läuft der Verkehr mit dem letzten weiter. Die Ausnahmen sind wenige und benannt: Ein Aufruf, der eine gespeicherte Antwort oder eine hochgeladene Datei nennt, liest deren Eintrag, eine aufbewahrte Antwort wird geschrieben, bevor sie ausgeliefert wird, und der Cache wartet standardmäßig 100 ms auf Valkey und macht ohne ihn weiter, wenn er ausfällt.
Organisationen, Workspaces und Schlüssel
Eine Organisation ist ein Kunde oder eine große Einheit. Ein Workspace ist eine Anwendung, ein Projekt, eine Umgebung oder ein Team und besitzt seine Schlüssel, Templates, Limits, Einstellungen und Nutzung. Zwei Regeln decken jede Einschränkung ab: Allow-Listen werden geschnitten und numerische Obergrenzen nehmen das Minimum.
Anbieterschlüssel gehören der Installation, einer Organisation oder einem Workspace, und ein Aufruf nutzt den nächstliegenden: den eigenen des Workspaces, dann den seiner Organisation, dann den gemeinsamen der Installation. Einen Schlüssel, den das Gateway bereits speichert, kann man an eine Organisation oder einen Workspace darunter weitergeben, ohne ihn erneut einzugeben; das Geheimnis verlässt das Gateway nie.
Rollen stehen in einer Datei, authz/gw.yaml, aus der die Prüfungen des Kerns und der Konsole
erzeugt werden:
| Rolle | Was sie abdeckt |
|---|---|
| Platform-Admin | Anbieter, Zugangsdaten, Modelle, Preise, Organisationen, Personen |
| Organisations-Admin | Ihre Einstellungen, Workspaces, Mitglieder und Freigaben |
| Workspace-Admin | Templates, Schlüssel, Limits, Einstellungen und Audit-Modus eines Workspaces |
| Auditor | Liest Konfiguration, Nutzung und Audit-Mode-Aufzeichnungen |
| Viewer | Liest Konfiguration und Nutzung; keine Geheimnisse, keine Audit-Mode-Aufzeichnungen |
Aufrufe tragen Zuordnungen — end_user, session_id, trace_id, deklarierte Tags, agent_id,
task, complexity —, die Reports, Limits und Routing auswerten. Personen melden sich an der
Konsole mit lokalen Konten an oder, mit PGW_AUTH=oidc, über pacod-id: Das Gateway registriert
dort seine Organisationen und Workspaces und folgt dem Feed der Rollen, und eine beendete Sitzung
wird binnen zwei Sekunden abgewiesen.
Limits und Kosten
Ein Limit gilt für eine Organisation, einen Workspace, einen Schlüssel oder einen Endnutzer. Es
zählt Tokens, Anfragen oder Ausgaben pro Minute, Stunde, Tag, Woche, Monat oder insgesamt und lehnt
Aufrufe entweder ab (429, 402) oder zählt und berichtet nur. Anwendungen können den
Kontingentstand eines Nutzers über GET /gw/v1/quota abfragen. Die Zähler werden etwa einmal pro
Sekunde über PostgreSQL zwischen den Instanzen zusammengeführt, sodass ein Limit um etwa eine
Sekunde Verkehr überschritten werden kann.
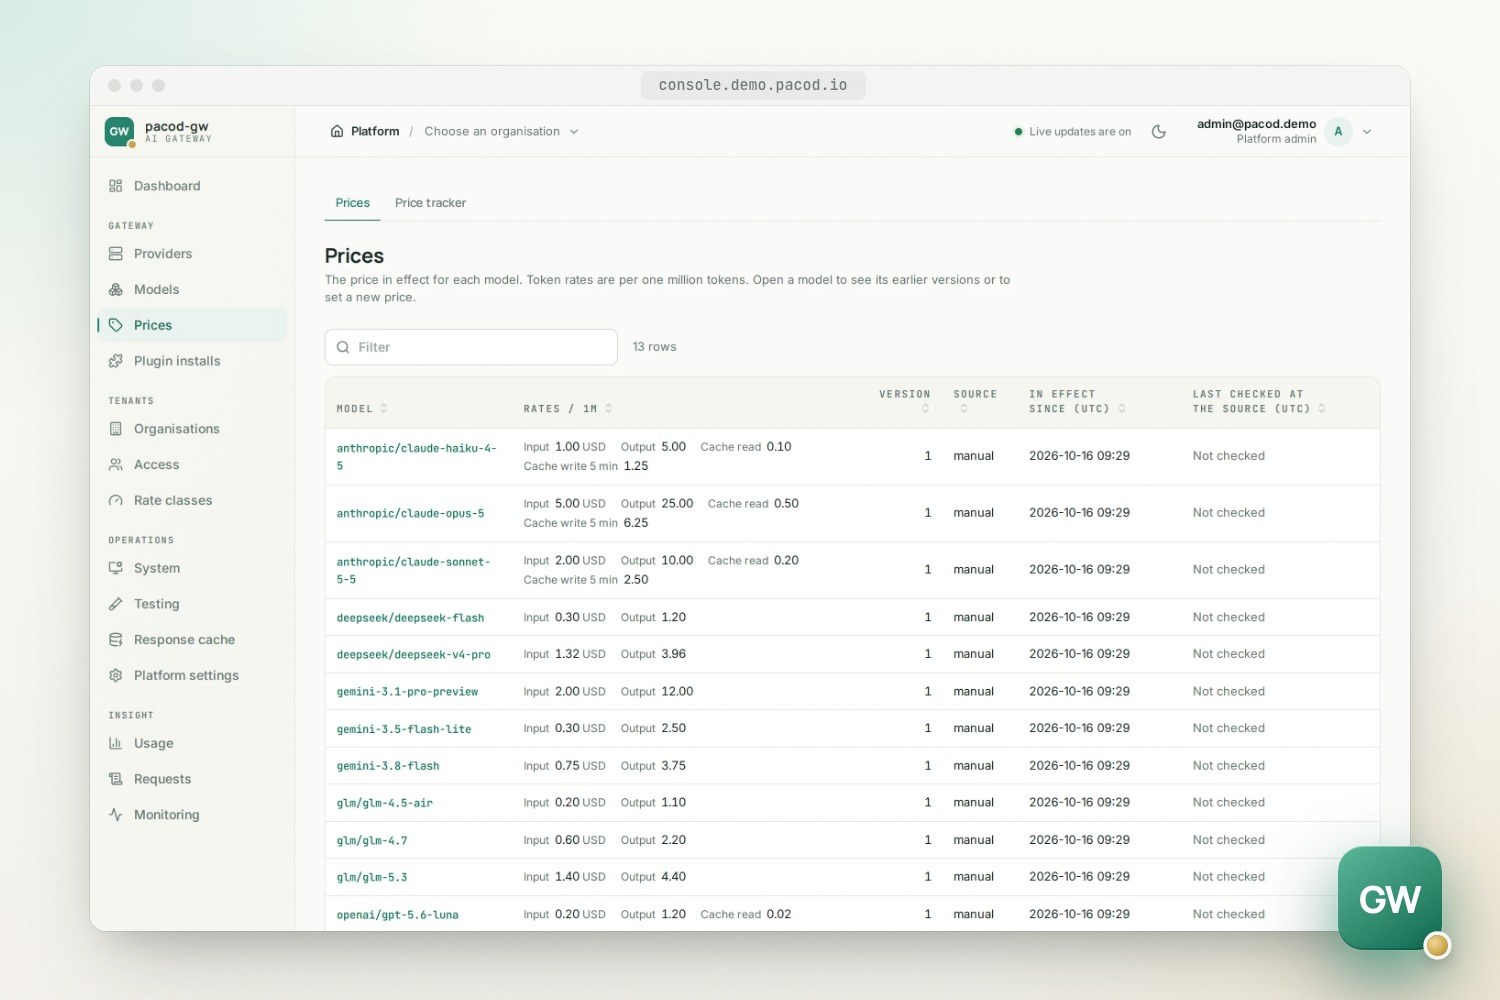
Jeder Aufruf wird beim Abschluss bepreist, aus einem versionierten Preis. Tokens kosten pro Million, mit eigenen Sätzen für Cache-Lesen und -Schreiben, Reasoning sowie Audio- und Bild-Tokens, wo der Preis sie hat, dazu Batch-Varianten, Stufen nach Eingabegröße und Off-Peak-Fenster. Zeichen der Sprachausgabe, Bilder, Sekunden Audio, Search Units, Tool-Aufrufe beim Anbieter und Anfragen haben Stückpreise. Einen Standardpreis gibt es nicht: Ein Modell braucht einen Preis oder ein ausdrückliches „kostenlos“, um aktiviert zu werden.
Die Modellerkennung fragt jeden Anbieter, standardmäßig einmal täglich, nach seiner Modellliste und schlägt die Modelle vor, die dem Gateway fehlen; ein aus einem Vorschlag hinzugefügtes Modell bleibt ein Entwurf, bis es einen Preis hat. Ein geplanter Preis-Tracker liest die Preisliste von LiteLLM oder die Preisseite eines Anbieters und übernimmt Änderungen innerhalb einer festgelegten Grenze oder schlägt sie zur Freigabe vor. Solange er keine Quellen hat, schlägt die Konsole die Liste von LiteLLM für OpenAI, Anthropic, Gemini, DeepSeek und z.ai vor.
Antwort-Cache
Anwendungen schicken oft dieselbe Anfrage zweimal: eine Testsuite, eine Klassifizierung mit
Temperatur 0, eine Seite, die das Modell für jeden Besucher dasselbe fragt. Der Antwort-Cache
beantwortet einen solchen Aufruf mit der Antwort, die das Modell schon einmal gegeben hat, ohne den
Anbieter zu fragen. Er ist ein Plugin, response_cache, standardmäßig installiert: in einer neuen
Installation aus, bis ein Administrator ihn einschaltet, und an im Entwicklungs-Stack und in der
Demo.
„Dieselbe Anfrage“ heißt: Dasselbe Modell bekam denselben Body, nachdem das Template angewandt und der Body für das Modell geformt wurde. Ein Stream und eine ganze Antwort teilen sich eine aufbewahrte Antwort, und sie wird im eigenen Dialekt des Aufrufers zurückgeschrieben. Ein Treffer kostet nichts: kein Aufruf beim Anbieter, Kosten 0, kein Slot des Schlüssels, kein Limit gezählt. Sein Usage-Event hält fest, was er gespart hat, und ein Report zeigt Treffer, Fehlschläge und Ersparnis über die Zeit, nach Modell und nach Workspace.
| Einstellung | Standard | Was sie entscheidet |
|---|---|---|
mode |
off (neue Installation) |
enforce antwortet aus dem Cache; shadow vermerkt nur would_hit, um zuerst die Trefferquote zu sehen |
calls |
deterministic |
Aufrufe mit Temperatur 0, oder all |
scope |
key |
Wer Antworten teilt: ein API-Schlüssel, ein Endnutzer eines Schlüssels oder der ganze workspace |
ttl_seconds |
3600 | Wie lange eine Antwort aufbewahrt wird, höchstens eine Woche |
max_answer_bytes |
1 MiB | Größere Antworten werden nicht aufbewahrt |
Die Plattform setzt einen Standard, den eine Organisation oder ein Workspace ersetzen kann; eine
Organisation kann ihre Wahl sperren. Ein Aufrufer entscheidet pro Aufruf mit x-gw-cache: off,
refresh oder on, und die Antwort meldet im selben Header hit, miss, would_hit, refresh
oder bypass, bei einem Treffer mit Age. Gecacht werden nur Managed-Aufrufe: nicht der
Proxy-Modus, Embeddings, Sprachausgabe, Token-Zählungen, Batches oder die eigenen Aufrufe des
Gateways. Ablehnungen, abgebrochene Streams und Antworten, die eigene Tools des Anbieters genutzt
haben, etwa eine Websuche, werden nie aufbewahrt.
Die Antworten liegen in Valkey (gw-valkey), das sich alle Gateways teilen und das sie nur im
Arbeitsspeicher hält. Jede wird mit AES-256-GCM versiegelt, unter einem Schlüssel, der für ihren Workspace aus dem
Key-Encryption-Key abgeleitet ist, und unter einem Namen, der ein schlüsselabhängiger Hash der Anfrage
ist: Wer Valkey liest, erfährt weder, was gefragt, noch, was geantwortet wurde, und eine Antwort,
die sich nicht öffnen lässt, ist ein Fehlschlag. Antworten wechseln nie zwischen Workspaces. Ein
Administrator leert einen Workspace, eine Organisation oder die ganze Plattform auf einmal, und die
Audit-Regel forbid schaltet den Cache überall dort ab, wo sie gilt.
Routing und Intent
Ein Template kann einen Pool von Modellen mit Tiers, Gewichten und Prioritäten enthalten. Ohne
weitere Einrichtung bedient das erste Modell, und das nächste übernimmt bei einem 429, einem 5xx oder
einer verlorenen Verbindung. Ein Routing-Schema ergänzt Regeln auf das, was der Aufrufer angibt
(complexity, task, Tags, Eingabegröße oder ein CEL-Ausdruck), und Algorithmen: Priorität,
gewichtet, Round Robin, geringste Latenz und günstigster Preis, optional mit Session-Affinität, damit
Prompt-Caches warm bleiben. Ein Circuit Breaker stellt ein fehlerhaftes Modell zurück, und jede
Antwort nennt in x-gw-route die Regel, die sie geroutet hat.
Das Intent-Plugin beantwortet die Frage „Wofür ist dieser Aufruf?“ anhand eines Katalogs, den die Organisation oder der Workspace schreibt, mit einem LLM, der Jev-Engine oder einer Kaskade aus beiden. Sein Urteil kann einen Aufruf blockieren, routen, auf Limits pro Intent anrechnen oder zur Prüfung markieren; es kann zunächst im Schattenmodus laufen und verändert die Konversation nie.
Ein neuer Katalog beginnt mit einer eingebauten Vorlage, starter, mit den Intents eines
allgemeinen Assistenten und Regeln, die markieren und blockieren. Ein neues Binding beginnt mit
einer Vorlage, die das Gateway für seinen Geltungsbereich ausfüllt: Schattenmodus, dieser Katalog
und das günstigste freigegebene Modell, das nach einem JSON-Schema antwortet, oder Jev, wenn es
keines gibt. Die Panels zum Ausprobieren und Bewerten in der Konsole lassen die Engines auf
Beispieltexten laufen, zuerst auf Demodaten, die für den Katalog erstellt werden, sodass sich die
Engines vergleichen lassen, bevor ein Binding durchsetzt.
Siehe den Routing-Leitfaden und das
Plugin-Konzept.
Observability und Audit
Usage-Events erreichen den Analysedienst in Batches aus dem Spool jeder Instanz; die Zustellung erfolgt mindestens einmal, und ClickHouse entfernt Duplikate. Der Dienst erstellt Reports zu Nutzung, Fehlern, Gateway-Verzögerung, Rankings, Endnutzern und dem Antwort-Cache, mit CSV-Export, und führt die geplanten Jobs aus. Die Konsole erreicht ihn nur über den Kern, der die Rolle des Aufrufers prüft und den Geltungsbereich erzwingt.
Prometheus, Grafana-Dashboards, Alertmanager-Regeln und OpenTelemetry-Traces decken den Betrieb ab; die Konsole zeigt Live-Kennzahlen, den Zustand der Anbieter und offene Alarme.
Der Audit-Modus speichert vollständige Aufrufe zur Fehlersuche: die Anfrage, jeden Versuch beim Anbieter und die Antworten. Er ist standardmäßig aus, eine Organisation kann ihn vorschreiben oder verbieten, Zugangsdaten werden vorher entfernt, und Aufzeichnungen laufen standardmäßig nach 14 Tagen ab. Realtime-Sitzungen und die Aufrufe zu Dateien und Batches werden aufgezeichnet, wo der Workspace es zusätzlich verlangt. Was das Gateway ungelesen weiterleitet — eine WebSocket-Sitzung im Proxy-Modus, ein im Proxy-Modus angelegter Batch —, lässt sich nicht aufzeichnen, und ein Workspace kann es ablehnen, statt es ohne Aufzeichnung zu bedienen.
Sicherheitsmodell
- Anbieterschlüssel werden pro Zugangsdatensatz mit AES-256-GCM versiegelt, unter einem Key-Encryption-Key aus der Umgebung oder einer Datei, nie aus der Datenbank. Die API zeigt nur einen Fingerabdruck.
- Gateway-Schlüssel (
pgw_…) tragen 32 Zufallsbytes, werden als HMAC-SHA256 mit Pepper gespeichert und einmal angezeigt. - Mandantentrennung. Der Workspace ergibt sich aus dem Schlüssel, nie aus der Anfrage; der Kern beschränkt Reports auf das, was die Rollen des Aufrufers erlauben, und Antworten aus dem Cache wechseln nie zwischen Workspaces.
- Die Management-API lauscht nur in
pacod-admin-net, einem internen Netzwerk ohne Weg nach draußen, dem nur ihre serverseitigen Clients beitreten: die Konsole, der Analysedienst und der Tester, im kompletten Stack auch die Produkte, die sie oder pacod-id aufrufen. Ein Container, der nur im gemeinsamen Netzwerk ist, erreicht sie nicht. Die Konsole sendet mit jeder Seite eine Content-Security-Policy. - Die Datenbankrolle. Der Kern besitzt seine eigene Datenbank und ist nicht der Superuser von PostgreSQL; die Datenbank von pacod-id ist ihm verschlossen.
- Ausgehende Verbindungen zu Anbietern und Preisquellen werden nach der Namensauflösung geprüft: Private und Link-Local-Adressen werden abgelehnt, sofern ein Betreiber sie nicht freigibt.
- Prompts bleiben aus Logs, Metriken und Traces heraus, die nur Metadaten enthalten. Bodies werden nur dort aufbewahrt, wo jemand es gewählt hat: im Audit-Modus, bei gespeicherten Antworten und in den versiegelten Antworten des Caches.
Das Bedrohungsmodell nennt auch, was offen bleibt: Der Metrik-Port hat keine Authentifizierung und trägt Mandanten-Labels, wer den Key-Encryption-Key hält und in Valkey schreiben kann, könnte Antworten in den Cache legen, und das Repository hat kein CI, sodass seine Abhängigkeitsprüfungen nur laufen, wenn jemand sie startet.
Deployment und Betrieb
Der Kern läuft als all oder aufgeteilt in gateway-Instanzen und eine admin-Instanz. Die
Instanzen teilen sich eine PostgreSQL und, für den Antwort-Cache, ein Valkey; sonst nichts.
| Layout | Dateien |
|---|---|
| Ein Kern | deploy/docker-compose.yml mit docker-compose.standalone.yml |
| Mehrere Gateways auf einem Host | zusätzlich docker-compose.scale.yml |
| Gateways auf anderen Maschinen | docker-compose.hub.yml zentral, deploy/node/ auf jeder Maschine |
| Kubernetes | deploy/helm/pacod-gw, mit eigener PostgreSQL, eigenem ClickHouse und Valkey |
| Minimales Gateway | deploy/lite/docker-compose.yml |
Wie jedes pacod-Projekt tritt das Gateway dem gemeinsamen Docker-Netzwerk pacod-net bei, in dem
jeder Dienst einen eigenen Namen hat: Der Kern heißt pacod-gw, die übrigen Dienste gw-*. Die
Listener, die nur Server erreichen, liegen in einem zweiten, internen Netzwerk, pacod-admin-net.
docker-compose.yml enthält die eigenen Dienste des Gateways, darunter ClickHouse und Valkey;
docker-compose.standalone.yml ergänzt seine Kopien der gemeinsamen Komponenten: PostgreSQL,
pacod-id, Caddy und Monitoring. pacod-demo betreibt das
Gateway zusammen mit den anderen pacod-Projekten unter demo.pacod.io: Es
lädt nur die erste Datei und startet jede gemeinsame Komponente einmal.
Aufrufe fließen weiter, wenn PostgreSQL, ClickHouse, der Analysedienst oder Valkey ausfallen: Der Kern arbeitet mit seiner letzten Konfiguration, sammelt Events im Spool und behandelt jedes Nachschlagen im Cache als Fehlschlag. Caddy terminiert TLS und schickt jeden Aufruf an das bereite Gateway mit den wenigsten laufenden Aufrufen. Das Runbook behandelt Geheimnisse, Backup und Wiederherstellung, Schlüsselrotation, Upgrades und Fehlersuche.
pacod-gw-lite behält Übersetzung, Streaming, Wiederholungen und Failover, mit Limits pro
Schlüssel im Speicher und einer Logzeile pro Aufruf mit ihren Kosten. Sein Antwort-Cache ist
standardmäßig aus und lebt in seinem eigenen Speicher (PGW_CACHE_MODE); Dateien und Batches
brauchen ein Verzeichnis für ihren Eintrag (PGW_OBJECTS_DIR). Seine Clients teilen sich die
Anbieterschlüssel und sind beim Anbieter nicht voneinander getrennt. Im gemeinsamen Netzwerk heißt
das minimale Gateway ebenfalls pacod-gw, daher läuft auf einem Host entweder es oder das
vollständige Gateway (Details).
Was getestet ist
- OpenAI, Anthropic, Gemini, DeepSeek und GLM werden mit Live-Aufrufen geprüft; Kimi, Ollama, xAI und Vertex AI nur gegen ihre Dokumentation und den Mock-Anbieter.
- Die erste Installation laut Runbook wurde aus einem frischen Klon auf einer Maschine (Docker Desktop unter macOS, 2026-10-05) durchgespielt, Backup und Wiederherstellung eingeschlossen. Das Layout mit drei Gateways nahm 40.000 Lastaufrufe über den Balancer ohne einen fehlgeschlagenen Aufruf.
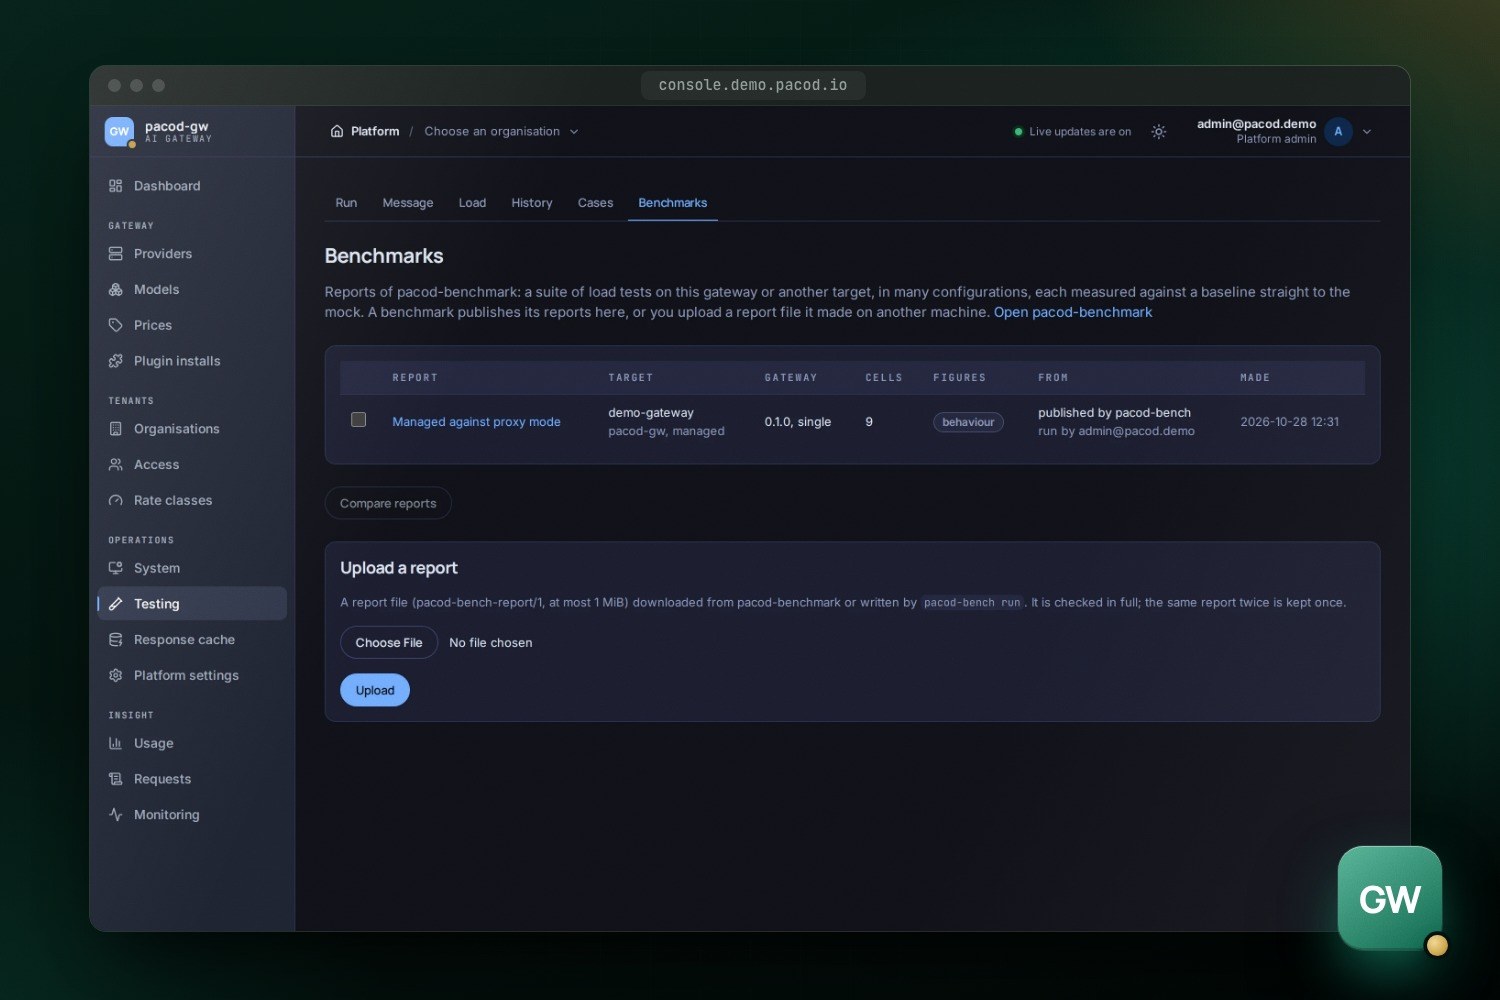
- Die Seite Testing der Konsole führt Testfälle und Lasttests gegen eine laufende Installation aus und zeigt die Berichte von pacod-benchmark, das misst, was das Gateway gegenüber einer Baseline direkt zum Mock hinzufügt. Ein Lauf, dessen Lastagenten im eigenen Stack des Gateways liefen, wird als Verhalten markiert, nicht als Kapazität.
- Das Designziel von 10.000 gleichzeitigen Streams im Proxy-Modus und 5.000 im Managed-Modus pro Instanz (2 CPUs, 1 GB) ist noch nicht durch einen Lasttest bestätigt.
- Noch nicht erprobt: Let's-Encrypt-Zertifikate, ein Linux-Host, Gateways auf physisch getrennten Maschinen mit TLS dazwischen, ein Upgrade zwischen Releases und das Helm-Chart auf einem echten Cluster. Das minimale Gateway ist noch auf keinem Server gelaufen.
- Nicht im ersten Release: MCP- und Tool-Governance sowie Content-Guardrails.
Die Seite zur Architektur zeigt, wie der Code aufgebaut ist und wo er vom Designkonzept abweicht.
Schnellstart
Der komplette Stack mit einem Mock-Anbieter
make test-services
make verify
make dev-up
make smoke-mock
open http://localhost:13000
Das minimale Gateway
make lite-dev-up
make lite-smoke
Funktioniert mit
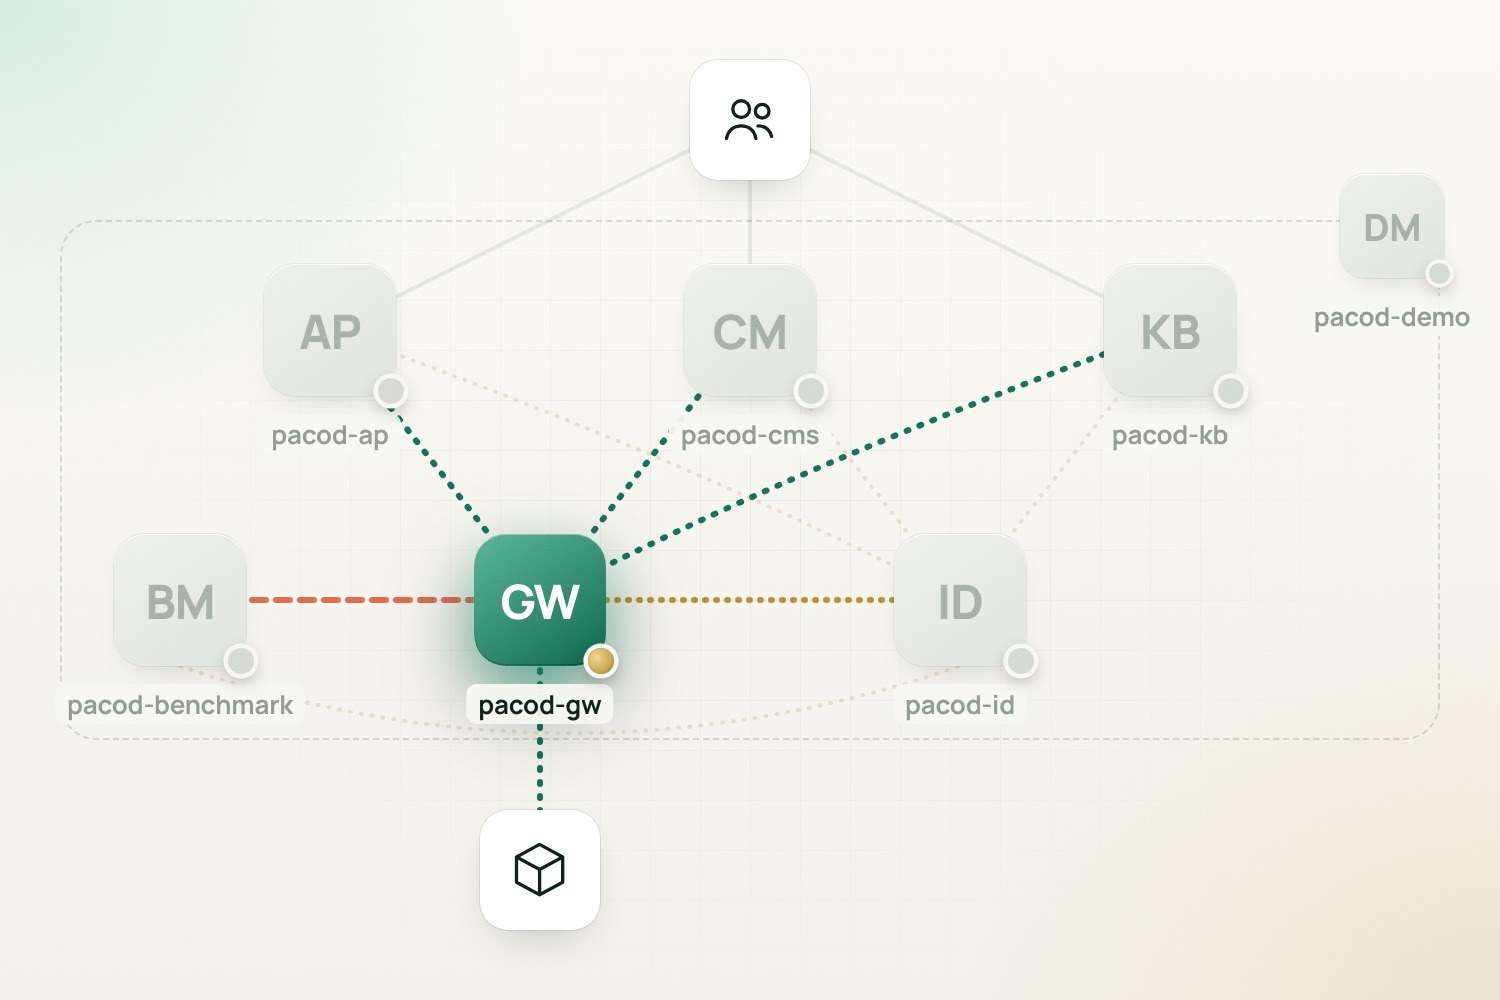
- pacod-id: Mit PGW_AUTH=oidc melden sich Personen über pacod-id an der Konsole an; das Gateway registriert dort seine Organisationen und Workspaces und folgt dem Feed der Rollen.
- pacod-ap: Jeder LLM-Aufruf eines Agenten läuft über das Gateway, das Modelle, Preise, Schlüssel und Nutzung verwaltet.
- pacod-cms: Die KI-Übersetzung im Studio ruft das Gateway auf, sodass das CMS nie einen Anbieterschlüssel hält.
- pacod-kb: Der optionale LLM-Bereinigungsschritt der Wissensdatenbank und die optionale zweite Meinung ihrer Inhaltsprüfung werden vom Gateway geroutet, bepreist und zugeordnet.
- pacod-demo: Betreibt das Gateway neben den anderen Produkten, mit eingeschaltetem Antwort-Cache und seinem Mock-Anbieter, solange kein Anbieterschlüssel gesetzt ist.
- pacod-benchmark: Misst, was das Gateway hinzufügt, mit den Lastagenten des Gateways und gegen eine Baseline direkt zum Mock, und veröffentlicht seine Berichte in der Konsole unter Platform → Testing → Benchmarks.