
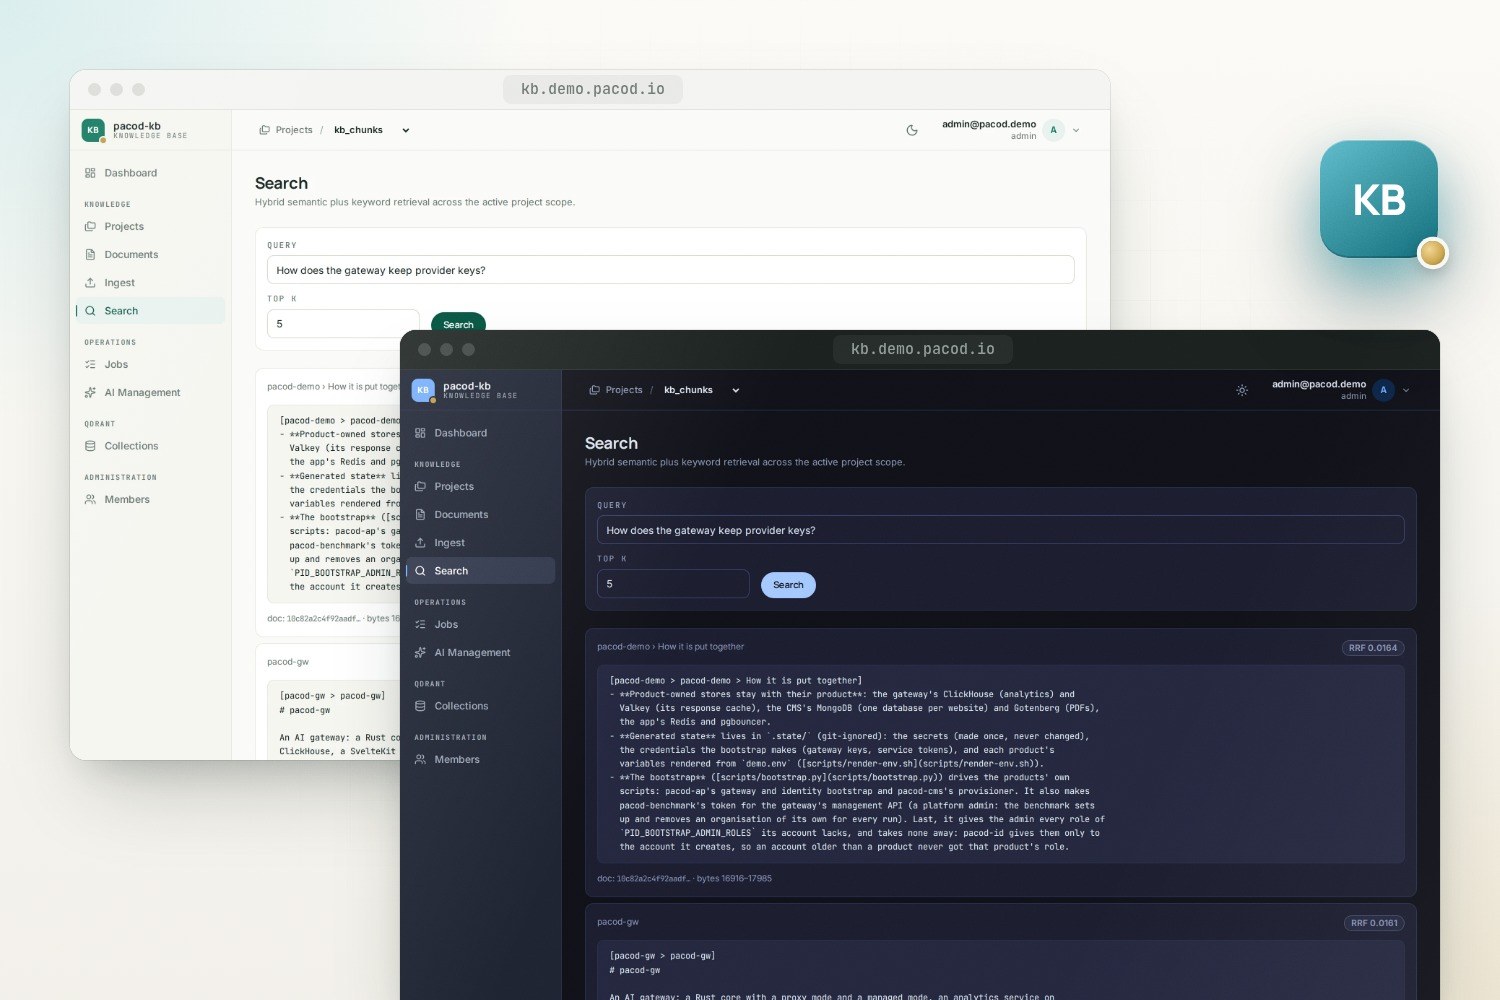
pacod-kb зарежда файлове и уеб страници, преобразува ги в каноничен Markdown, индексира ги за хибридно семантично търсене и търсене по ключови думи и пази всяка версия. Проверява всеки документ за prompt injection, преди нещо да бъде индексирано, и подава на моделите надолу по веригата фрагменти, които те могат да цитират, по документиран договор за метаданните. Работи на CPU, а търсенията остават отзивчиви, докато се зареждат документи.
RAG база знания
- Лиценз: Apache-2.0
- Версия: 1.0.0 · Стабилна
- Написан на: Python
- Технологии: FastAPI, HTMX, docling, BGE-M3, Qdrant, SQLite FTS5, PostgreSQL, Docker
- Вижте в GitHub · Докладвайте проблем
Възможности
Зарежда всичко
PDF, DOCX, HTML, Markdown, текст и JSON — качени, пуснати в папка, изтеглени от URL или наблюдавани за промени.
Каноничен Markdown
Заглавията се разпознават в правни текстове на осем езика, в научни публикации и в статии; номерата на страници, колонтитулите и шаблонният текст се филтрират.
Сигурност на съдържанието
Многостепенна проверка за prompt injection и спам блокира документа или го поставя под карантина, преди да бъде индексиран; резултатите от търсенето се ограждат като недоверени данни.
Хибридно търсене
Плътни вектори от BGE-M3 в Qdrant плюс индекс по ключови думи, обединени чрез reciprocal rank fusion, в проекти, които никога не виждат документите един на друг.
Всяка версия се пази
Новата версия заменя старата, която остава достъпна за търсене по дата; наблюдавана страница, която се върне към предишно състояние, възстановява по-ранната версия.
Калибрирана релевантност
Незадължителен cross-encoder reranker дава оценка на релевантността от 0 до 1, сравнима между заявките, така че min_score може да отсее резултатите, които не са отговор.
Договор за потребителите
Всеки фрагмент носи стабилен идентификатор, пътя си от заглавия и байтови отмествания в съхранения Markdown, документирани поле по поле.
Създаден за CPU
Заявките минават пред работата по зареждането и чакат най-много един малък пакет; ембедингите могат да идват и от обща услуга.
Уеб интерфейс и CLI
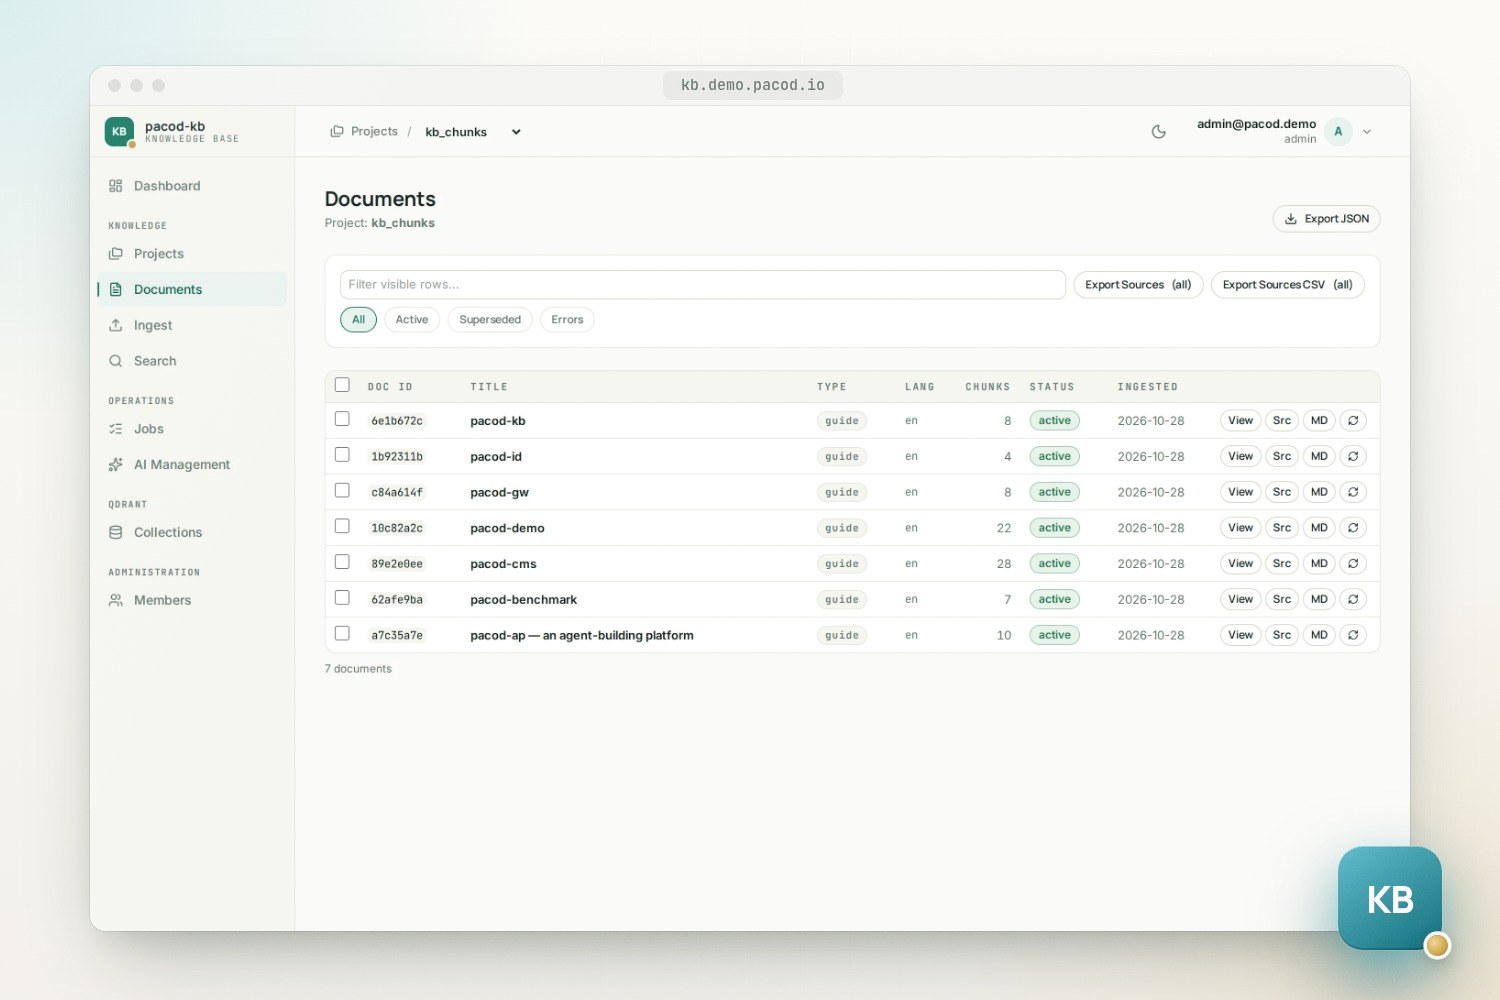
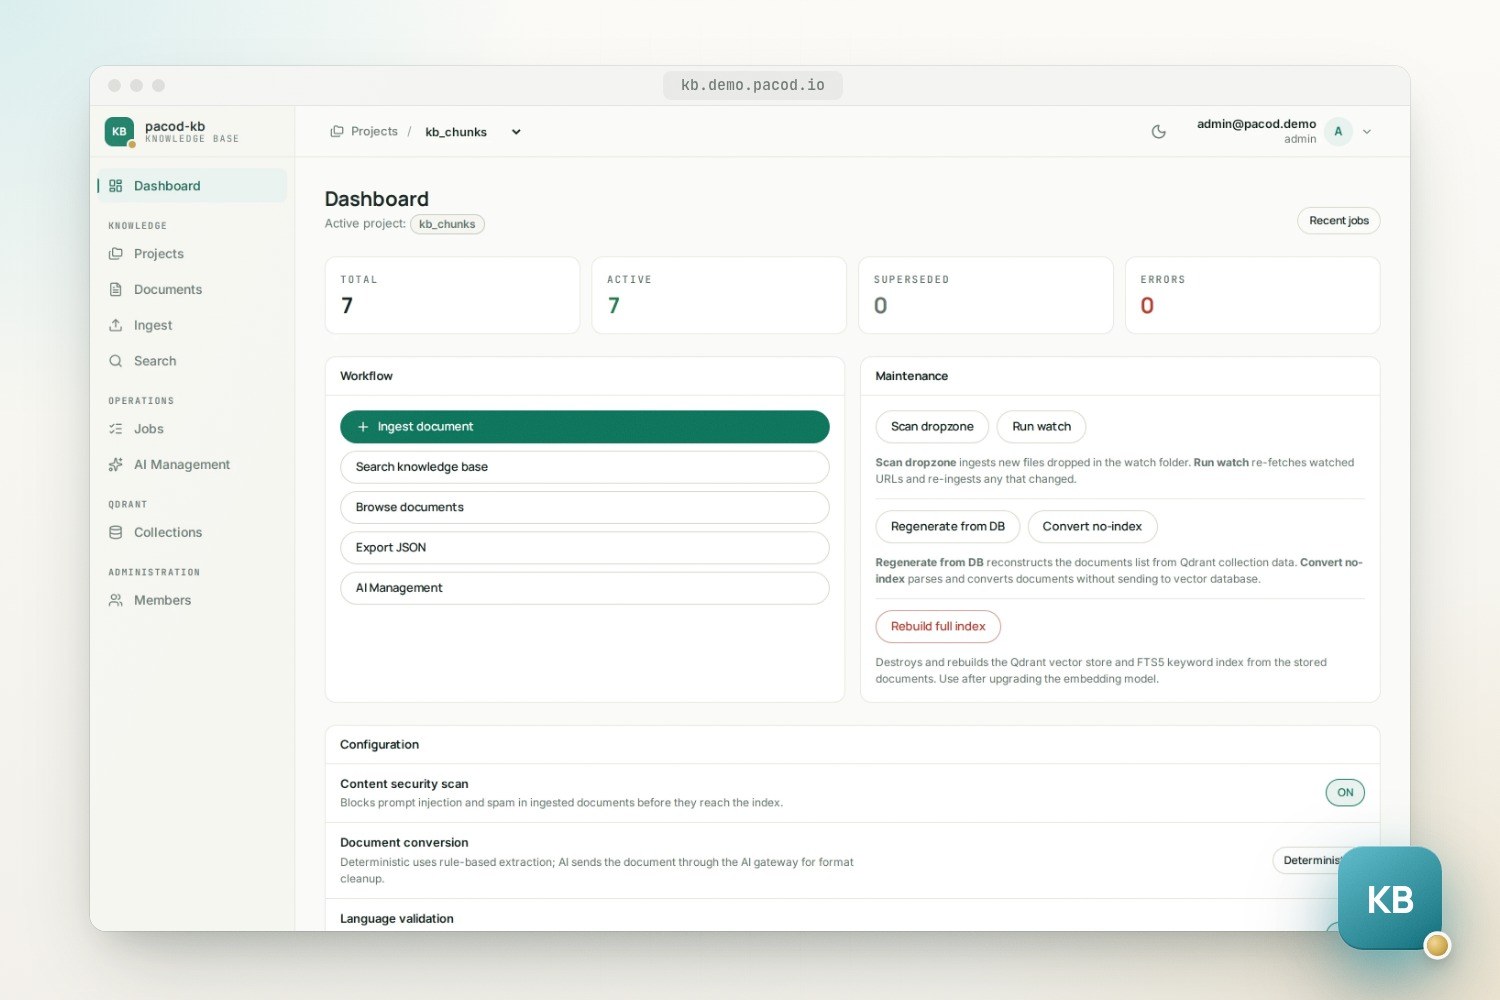
Уеб интерфейс с общия облик на pacod, светъл или тъмен, за документи, проекти, задачи, използване и разходи за AI и членове; CLI kb за зареждане, търсене, наблюдение, повторно изграждане и експорт.
Екранни снимки
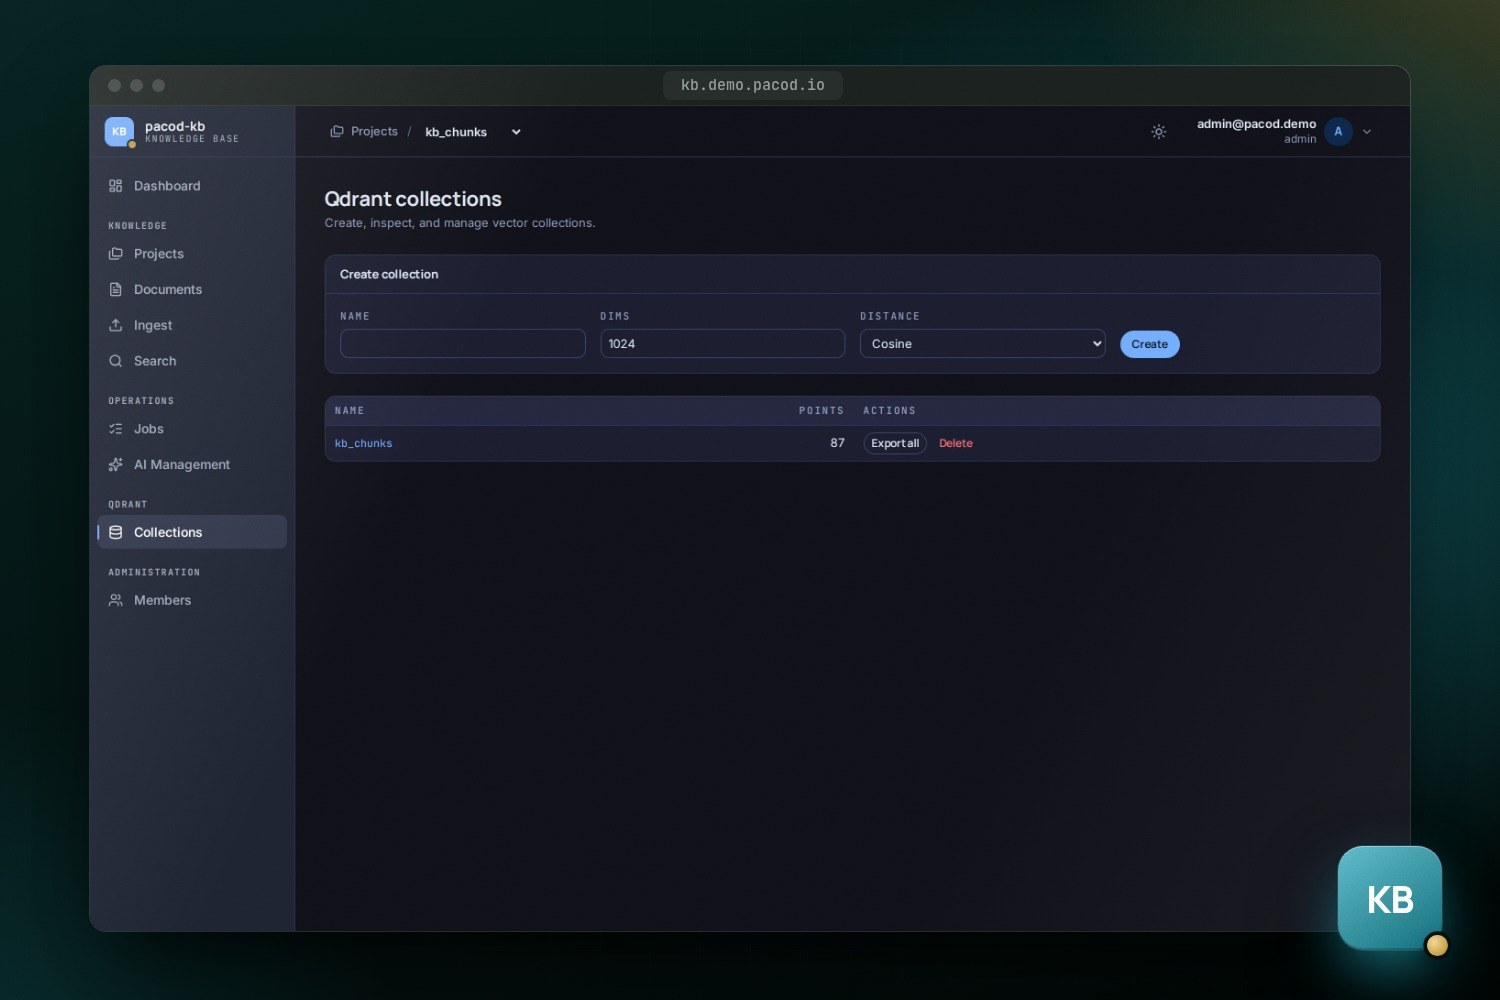
Защо съществува
По-голямата част от работата в retrieval-augmented generation се случва, преди моделът да прочете и дума: да вкараш документите, да ги поддържаш чисти, да намериш правилния пасаж и да кажеш на модела откъде идва. pacod-kb е точно тази част, изградена като самостоятелна услуга с HTTP API, уеб интерфейс и CLI.
Три изисквания са я оформили:
- Отговорите трябва да могат да се цитират. Всеки фрагмент носи пътя си от заглавия и байтови отмествания в стабилен Markdown текст, така че потребителят може да го цитира, да постави връзка към него и да извлече контекста му.
- Източниците се променят. Нищо не се презаписва: новата версия заменя старата, която остава достъпна за търсене по дата.
- Зареденият текст е недоверен вход за модела. Той се проверява за prompt injection, преди да бъде индексиран, и се огражда като данни на изхода.
Документ, стъпка по стъпка
Документът минава по един и същ път, независимо дали е качен, пуснат в папката dropzone, изтеглен от URL или изтеглен отново от наблюдаван уеб източник:
- Приемане. SHA-256 на байтовете на източника е идентификаторът на документа; познат идентификатор се пропуска, така че един и същ файл никога не се зарежда два пъти.
- Парсинг. PDF през docling, с незадължително OCR за сканирани страници (ако е инсталиран tesseract, два OCR двигателя се сравняват страница по страница), DOCX, HTML, Markdown, текст и JSON, чиито ключове стават заглавия. Резултатът е Markdown с YAML front matter.
- Проверка на езика. Приемат се английски, немски, български, руски, сръбски, македонски,
хърватски и словенски; другите езици се отказват, преди нещо да бъде записано. Текст, чийто
език не може да бъде разпознат, се приема като
unknown, с предупреждение. - Проверка на детерминистичния парсинг за prompt injection и спам. Тя става, преди какъвто и да е модел да види текста: преобразувателят би могъл да изпълни вмъкнати инструкции, а преобразуването би премахнало символите с нулева ширина и скритата маркировка, които проверката търси.
- Преобразуване, по желание. LLM обработка през pacod-gw подрежда Markdown-а; PDF до 20 MiB стига до модела като файл, всичко останало — като извлечен текст. Документ под карантина никога не се изпраща. Прекъснат, отказан или празен отговор запазва детерминистичния парсинг, а преобразуваният текст се проверява втори път.
- Почистване и структуриране. Филтър за шум премахва номера на страници, колонтитули, известия за бисквитки и блокове от навигационни връзки. Заглавията се повишават в правни кодекси, регламенти и директиви (осем езика) и в научни публикации; статия от URL получава и своя автор, дата и издание.
- Съхраняване на
document.md, манифест с дневника на жизнения цикъл и моментно копие на източника: в папки подKB_ROOTили в PostgreSQL. - Индексиране, само когато статусът на документа е
ok. Фрагменти до 500 токена, съобразени със заглавията, се вграждат с BGE-M3, всеки с пътя от заглавия[Title > Heading > Subheading]отпред (таблицата получава и абзаца преди нея), в колекцията на проекта в Qdrant и в неговия индекс по ключови думи. Фрагментите, които не са се променили от по-ранна версия, запазват векторите си.
Зарежданията от интерфейса или от API-то се изпълняват като задачи, една след друга, в собствен worker, никога в нишките, които отговарят на търсенията. В режим с база данни задачите се пазят в PostgreSQL, а рестартът маркира прекъснатите от него като неуспешни.
Архитектура
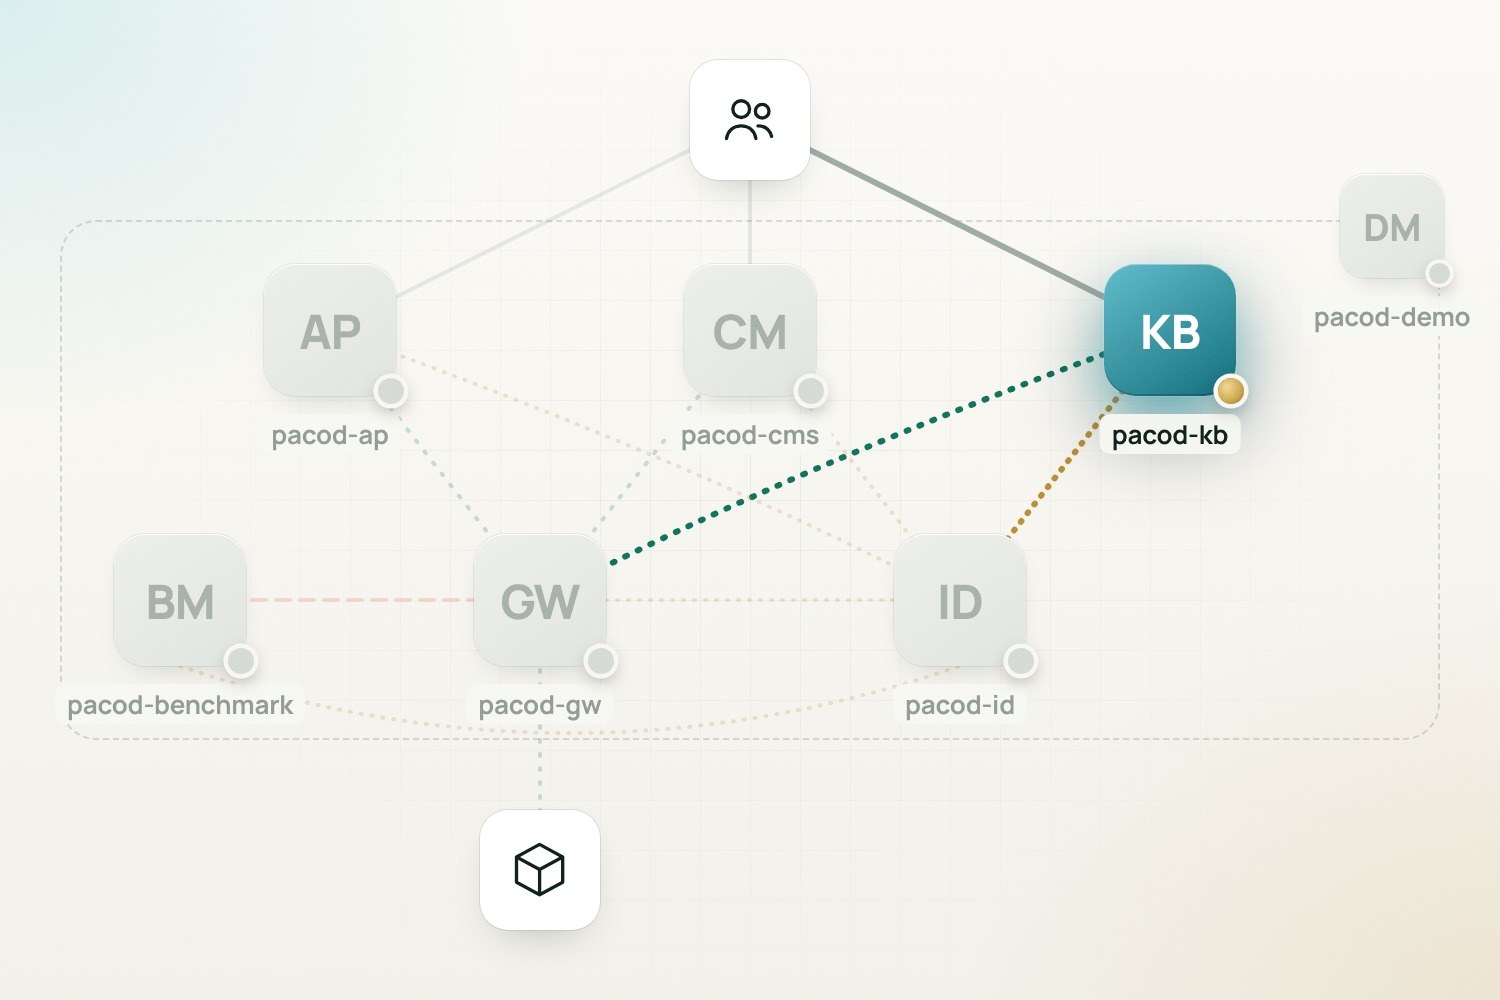
pacod-kb се състои от две услуги, kb-pipeline и kb-ui, както и от моделите и хранилищата, които
те ползват:
| Част | Роля |
|---|---|
Pipeline API (kb-pipeline, :8000) |
Зареждане, индексиране, търсене, задачи, настройки; единствената част, която вика AI шлюза |
Уеб интерфейс (kb-ui, :8080) |
FastAPI и HTMX; вход през pacod-id, сесии, членове, страниците; вика конвейера с API ключ |
| BGE-M3 | Ембединги с 1024 измерения, в собствения процес на конвейера или от услугата за ембединги на pacod-ap |
| Qdrant | Векторите: вграден в конвейера или сървър, който могат да споделят и други продукти |
| Индекс по ключови думи | SQLite FTS5 (BM25) при съхранение във файловата система, пълнотекстово търсене на PostgreSQL при съхранение в база данни |
| Документи и регистър | Папки под KB_ROOT или PostgreSQL; регистърът пази настройките, промптовете, използването и разходите за AI |
Разделението е умишлено. Конвейерът парсва недоверени документи и изтегля произволни URL адреси, затова не получава нито една от тайните на pacod-id; интерфейсът пък никога не вижда ключа за шлюза. Всеки контейнер получава изричен списък от променливи на средата, а един тест проверява този списък.
Всеки контейнер се включва в общата Docker мрежа pacod-net, където всеки може да достигне
останалите. Изключение е вътрешният слушател на pacod-id (токени, ключове за подписване, потокът за
оторизация, административното API): той отговаря само в pacod-admin-net, вътрешна мрежа без
изход навън, като pacod-id-internal:8071. kb-ui се включва в тази мрежа; конвейерът не е в нея и
не може да го достигне.
Кой какво е направил. Всяко извикване от интерфейса носи X-KB-Actor — идентификатора на
влезлия човек. Конвейерът му се доверява само заедно с API ключа, записва го към задачите,
промените в настройките и използването и го предава на шлюза. Когато pacod-id изтрие акаунт, kb
прекратява сесиите му, заменя този идентификатор с deleted-user навсякъде и едва тогава
потвърждава изтриването.
Търсене и какво получава моделът
Заявката минава през Qdrant и през индекса по ключови думи, а двете класирания се обединяват чрез reciprocal rank fusion: всеки списък добавя 1/(60 + ранг) за всеки фрагмент, който е намерил. Филтрите по дата и история се прилагат вътре в двете търсения, така че сто заменени фрагмента не могат да изместят единствения валиден.
Оценката по RRF подрежда един списък с резултати и не означава нищо между различни заявки. Оценка
0,0164 е 1/61: първо място в единия списък и отсъствие от другия. Точно това получават по
подразбиране повечето естествено формулирани въпроси, защото половината с ключови думи
(KEYWORD_QUERY_MODE=legacy) изисква съвпадение на всяка дума от заявката. Анализиращите режими
(or, and_or) вместо това премахват стоп думите и свеждат думите до основната им форма; те
остават изключени, докато оценка не покаже, че помагат.
Незадължителен cross-encoder, BAAI/bge-reranker-v2-m3, пренарежда най-добрите десет кандидата и
дава на всеки релевантност между 0 и 1, сравнима между заявките, така че min_score може да отсее
резултатите, които не са отговор. Той се зарежда във фонов режим, когато бъде включен, и никоя
заявка не го зарежда.
POST /query приема въпроса и филтрите му:
{"query": "maximum fine for a data breach", "top_k": 5, "as_of": "2025-12-30"}
Отговорът е {"results": [...], "reranked": false, "score_kind": "rrf"}. Всеки резултат
съдържа:
| Поле | За какво служи |
|---|---|
chunk_id |
Стабилен идентификатор, който кодира структурата от заглавия, а не пореден номер |
source_id |
Идентификаторът на документа: SHA-256 на байтовете на източника |
heading_path |
Път от заглавия като ["Chapter 1", "§ 5"], за цитиране и филтри по раздел |
byte_start, byte_end |
UTF-8 отмествания в съхранения Markdown текст |
valid_until |
Кога тази версия е заменена, или null, докато е актуална |
text |
Вграденият текст, ограден като недоверени данни |
score, rrf_score, rerank_score |
Оценката за подреждане и нейните съставки |
Отместванията са в байтове, а не в символи, което има значение за текст на кирилица:
body_bytes = body.encode("utf-8")
passage = body_bytes[result["byte_start"]:result["byte_end"]].decode("utf-8")
Всеки документ има и манифест: заглавие, източник, тип документ, статус, проект, парсерът или
моделът през шлюза, създал текста, и дневник на жизнения цикъл (ingested, superseded,
reinstated, security_flagged, review_flagged, llm_usage).
Версии и проекти
Нова версия, заредена с --supersedes, или променен наблюдаван източник маркира старата с
valid_until едновременно на четири места: във front matter, в манифеста, в индекса по ключови
думи и във векторните данни. Търсенията връщат актуалните фрагменти по подразбиране; as_of
връща валидното на даден ден; include_historical връща всичко. Ако наблюдавана страница се върне
към предишно състояние, по-ранната версия се възстановява. В режим с файлова система, с
GIT_AUTOCOMMIT=true, всяко зареждане се записва и като commit в git хранилище в KB_ROOT.
Проектът е изолирана колекция: собствена колекция в Qdrant и собствени редове в индекса по
ключови думи. Търсенето вижда един проект, повторното изграждане изтрива и попълва наново индекса
на един проект (--all-projects изгражда наново всеки в собствената му колекция), а смяната на
активния проект се отказва, докато има задача на опашката или в изпълнение.
Търсене, подкрепено с измервания
Стойностите по подразбиране идват от инструмент за оценка: 14 документа на шест езика (GDPR, Директивата за защита на данните в правоприлагането, четири конституции, статии от Wikipedia) и 92 ръчно написани заявки — перифрази, точни термини, междуезикови, на роден език и такива без отговор. Резултатът се брои, когато идва от раздела, посочен в етикета, така че етикетите остават валидни при промени в разделянето на фрагменти. Числата са измерени на процесора на машина за разработка (Apple M5, четири нишки) и документацията подчертава, че това не са продукционни числа:
| Измерване | Резултат |
|---|---|
| Правилният раздел е сред обединените кандидати | при всяка заявка с отговор |
| Правилният раздел е сред първите пет, без reranker | 98,7 % (R@1 0,83, около 50 ms) |
| С reranker, десет кандидата | R@1 0,91, около 2 s на заявка |
| Търсене, докато се зареждат документи (p50) | 24,3 s преди; 0,41 s сега, със задачи, изпълнявани една след друга |
| Вграждане при зареждане, пакети, сортирани по дължина | около 2,2× по-бързо, векторите са непроменени |
Оценката на reranker-а разделя отговорите от резултатите, които не са отговор: min_score 0.1
отсява 14 от 15 заявки без отговор и 2 от 70 верни първи отговора, докато оценките по RRF изобщо
не можеха да ги разделят. Въпреки това той е изключен по подразбиране: подобрението му остана
малко под прага при отделената за проверка половина, а латентността му тепърва трябва да се
потвърди на продукционния процесор.
Анализиращите режими за ключови думи помогнаха при заявките на роден език и с точни термини, но
загубите при междуезиковите и перифразираните бяха по-големи, а при отделената за проверка
половина загубиха: legacy остава по подразбиране.
Модел на сигурност
Сигурност на съдържанието. Проверката работи върху нормализирано копие на текста (нормализиран по Unicode, с малки букви, с отново слети думи, изписани с разредени букви) и прилага таблици с правила: фрази за injection на английски, немски, руски и български, трикове с обръщане на посоката на писане и със символи с нулева ширина, base64 и шестнадесетични блокове (декодирани и проверени отново), скрита маркировка и мерки за спам като плътността на връзките и повтарящите се редове. Всяко правило има тежест. Висока е само за недвусмислена подмяна на инструкциите („ignore previous instructions“), за знак за обръщане на посоката на писане и за инструкция, скрита в base64; фрази, които се срещат и в технически текстове, като „enable developer mode“, са с ниска тежест, така че едно-единствено съвпадение не може да блокира документ. Тестове проверяват, че дълги закони, сред тях GDPR, минават като чисти. Присъдата е една от три:
- block: находка с висока тежест или висока оценка на заплахата. Зареждането се проваля и нищо не се съхранява.
- quarantine: документът се пази със статус
review, никога не се преобразува и никога не се индексира. Само спам никога не води до блокиране. - clean: документът се индексира.
Незадължително второ мнение от LLM през шлюза (по подразбиране изключено) се иска само когато
правилата не са блокирали; то има 15 секунди и при грешка не блокира документа. Материал, за който
се знае, че е безопасен, може да прескочи проверката с kb ingest --trusted. На изхода /query
огражда всеки фрагмент като недоверени данни.
Изтегляне. Зарежданията от URL приемат само http и https, следват най-много пет
пренасочвания и проверяват всяка стъпка, а спират при 50 MB или 180 секунди; зареждане от URL
никога не чете локален файл. Две стойности по подразбиране са подходящи за лаптоп, а не за сървър:
задайте WEB_FETCH_ALLOW_PRIVATE=false, за да се отказват адреси, които водят до частни мрежи
(защита срещу server-side request forgery), и ALLOW_INSECURE_TLS=false, за да спре повторният
опит без проверка на сертификата след TLS грешка.
Хора. Интерфейсът вписва хората чрез pacod-id с OIDC и PKCE, на собствените страници на pacod-id, оформени с марката на kb. Той проверява токена за достъп, пази токените в криптирана сесия на сървъра и дава на браузъра бисквитка, която носи само случайна тайна. Ролите на kb са манифест, който интерфейсът изпраща на pacod-id при всяко стартиране; след това ролята на човека идва от потока за оторизация на pacod-id. Без роля в kb човек вижда страница „няма достъп“; ако копието на потока в интерфейса е по-старо от 60 секунди, страниците отговарят с 503, вместо да гадаят. Излизането прекратява сесията в pacod-id, а сесия, отменена там, приключва и в kb.
| Роля | Може |
|---|---|
| viewer | Четене и търсене |
| editor | Зареждане, повторно индексиране и изтриване на документи; изпълнение на задачи; управление на проекти |
| admin | AI Management, промптове, превключвателите по време на работа, членове |
Администраторите канят хора и сменят роли на страницата с членове, през административното API на pacod-id: показват се само ролите на kb, а последният администратор не може да бъде премахнат.
API-то на конвейера сравнява ключа си за постоянно време и при грешка отказва достъп: без
PIPELINE_API_SECRET всеки маршрут освен /health отговаря с 503.
Внедряване и експлоатация
docker-compose.yml съдържа собствените услуги на kb, kb-pipeline и kb-ui.
docker-compose.standalone.yml съдържа копията на kb от общите компоненти, които се включват с
профили на Compose: Qdrant, PostgreSQL, pacod-id с база данни до тази на kb, прихващач на поща и
шлюз за разработка — pacod-gw-lite пред фиктивните доставчици на pacod-gw, така че нищо не напуска
машината. make up зарежда и двата файла; нужни са му клонирани хранилища на pacod-id и pacod-gw
до това на kb, а на една машина може да работи само по едно копие от всеки общ компонент.
Фиктивният доставчик повтаря промпта, затова стекът за разработка оставя преобразуването
изключено; AI Management → Test model все пак минава целия път, включително цената.
В продукция насочвате kb към истински шлюз (pacod-gw с организация, работно пространство и ключ за kb или pacod-gw-lite с ключовете на доставчиците), поставяте pacod-id зад TLS или използвате вече съществуващ и премахвате профилите за разработка.
pacod-demo, достъпен на demo.pacod.io,
пуска kb заедно с останалите проекти на pacod. Той зарежда само файла на приложението на kb: kb
държи базата си данни в общия PostgreSQL и колекциите си kb_ в общия Qdrant, вгражда през общата
услуга за ембединги, а интерфейсът му се обслужва зад общия входен Caddy. Демото също оставя
преобразуването изключено.
- Хранилище.
KB_STORAGE_BACKENDеfilesystemилиdatabase; смяната не мигрира документите. - Данни. Директориите с данни са променливи (
KB_ROOT,KB_MODEL_CACHE,KB_QDRANT_DATA,KB_POSTGRES_DATA). Име без наклонена черта е Docker том; под macOSmake setupизползва томове. - Процесор.
TORCH_NUM_THREADS=0следва квотата на контейнера за процесор.EMBED_BATCH_TOKENS(1024) ограничава колко дълго една заявка може да чака зад зареждане. - Модели офлайн. Пуснете веднъж с достъп до мрежата, за да се напълни кешът на моделите, след
това задайте
HF_HUB_OFFLINE=1. - Общи модели. С
EMBEDDINGS_URLконвейерът вгражда през общата услуга за ембединги, вместо сам да зарежда BGE-M3: векторите са същите, така че нищо не се вгражда наново, а конвейерът има нужда от около 2 GB по-малко памет.RERANKER_URLправи същото за reranker-а. Ако моделът на тази услуга някога бъде сменен, индексът на kb трябва да се изгради наново. - Общ Qdrant. На Qdrant, който ползват и други продукти, страниците за Qdrant в интерфейса
показват и засягат само колекциите на kb (
KB_QDRANT_COLLECTION_PREFIX, по подразбиранеkb_). - Превключватели по време на работа. Таблото включва и изключва проверката на съдържанието, AI преобразуването и проверката на езика без рестарт; те не се запазват и при следващото стартиране отново важат променливите на средата.
- AI. Администраторите избират модели и редактират промптове в AI Management, където се виждат
и използването и разходите, отчетени от шлюза. Всяко извикване носи непрозрачна атрибуция
(функция, задача, проект, човек); при 429 извикването се повтаря веднъж, след изтичане на
Retry-After. Ако няма конфигуриран шлюз, AI е изключен и нищо друго не се чупи. - Логове. По едно събитие на ред в общия формат на pacod, JSON или текст (
LOG_FORMAT), на нивоLOG_LEVEL, без параметрите на заявките в URL. Docker пази пет файла по 10 MB за всеки контейнер.
Резервните копия обхващат KB_ROOT или базата данни на kb в PostgreSQL, хранилището на Qdrant
(или го изградете наново с kb rebuild --all-projects), базата данни на pacod-id заедно с ключа ѝ
за криптиране на ключове и .env.
Какво е тествано и какви са ограниченията
make check пуска ruff, mypy --strict и тестовете, които не се нуждаят от мрежа, от изтегляне на
модели, нито от работещ pacod-id или шлюз: тестовете на интерфейса влизат през истинския процес
срещу фалшив pacod-id. Моментни снимки на таблиците с маршрути на двете API-та улавят нежелани
промени, а CI пуска набора за оценка със заместващ модел за ембединги при всеки push, за да улови
отклонения в корпуса или в разделянето на фрагменти.
- Числата за търсенето са от една машина за разработка;
make eval-dockerги повтаря в образа на конвейера, ограничен до зададен брой процесори, както на продукционния хост. - Конвейерът и интерфейсът работят с по един worker: вграденият Qdrant държи заключване на файл, а управлението на сесиите в интерфейса предполага един процес.
- Reranker в собствения процес на конвейера приблизително удвоява паметта му; с
RERANKER_URLконвейерът не зарежда такъв. - Сръбският се приема, но детекторът на езици няма профил за сръбски, затова сръбски текст може да бъде разпознат грешно или отказан.
- kb няма крайна точка за метрики. Графиката за използването на AI зарежда Chart.js от CDN — единственият външен скрипт в интерфейса.
- Документирани за следващото повторно индексиране, но не включени: разредени вектори от BGE-M3 за половината с ключови думи, почистване на разделянето на фрагменти и изграждане в колекция-сянка преди превключване.
Повече подробности:
- Архитектура: контейнери, вход, шлюзът, кой какво е направил.
- Договор за метаданните: всяко поле на фрагмент и манифест.
- Оценка на извличането: пълните числа и решенията зад стойностите по подразбиране.
- Ръководство за експлоатация: разработка, продукция, експлоатация и отстраняване на проблеми.
- Миграции: надграждане на
съществуваща инсталация, включително преминаването към
pacod-netиpacod-admin-net.
Бърз старт
Стартиране с Docker
make setup
make up
open http://localhost:8080/kb
Разработка и оценка
uv sync
make check
make eval
Работи с
- pacod-id: Хората влизат през pacod-id; ролите viewer, editor и admin се предоставят там, а страницата с членове на kb използва неговото административно API.
- pacod-gw: Незадължителното LLM почистване и второто мнение при проверката, също незадължително, минават през шлюза, който държи ключовете на доставчиците, остойностява всяко извикване и го отчита.
- pacod-ap: Когато работи заедно с pacod-ap, kb може да вгражда и пренарежда през неговата обща услуга за ембединги, със същите вектори от BGE-M3.
- pacod-demo: Пуска kb заедно с останалите продукти, върху общите Qdrant, PostgreSQL и услуга за ембединги, зад общия входен слой.